使用 LangChain、Milvus、Anthropic Claude 3.5 Sonnet 和 Cohere embed-multilingual-v2.0 构建 RAG 聊天机器人
什么是 RAG
检索增强生成(Retrieval-Augmented Generation,简称 RAG)正引领生成式 AI,尤其是对话式 AI 的新潮流。它将预训练的大语言模型(LLM,如 OpenAI 的 GPT)与存储于向量数据库(如 Milvus、Zilliz Cloud)中的外部知识源相结合,从而让模型输出更准确、更具上下文相关性,并且能够及时融合最新信息。 一个完整的 RAG 系统通常包含以下四大核心组件:
- 向量数据库:用于存储与检索向量化后的知识;
- 嵌入模型:将文本转为向量表示,为后续的相似度搜索提供支持;
- 大语言模型(LLM):根据检索到的上下文和用户提问生成回答;
- 框架:负责将上述组件串联成可用的应用。
核心组件说明
本教程将带你在 Python 环境下,借助以下组件一步步搭建一个初级的 RAG 聊天机器人:
- LangChain: 一个开源框架,帮助你协调大语言模型、向量数据库、嵌入模型等之间的交互,使集成检索增强生成(RAG)管道变得更容易。
- Milvus: 一个开源的向量数据库,专门用于高效地存储、索引和搜索大规模向量嵌入,非常适合用于检索增强生成(RAG)、语义搜索和推荐系统等场景。如果您需要更具扩展性的解决方案,或不想管理自己的基础设施,我们推荐使用 Zilliz Cloud,这是一个基于开源项目 Milvus构建的全托管向量数据库服务,并提供支持最多 100 万个向量的免费套餐。
- Anthropic Claude 3.5 Sonnet: Claude 3系列中的这个先进模型旨在实现深刻理解和创造性的语言生成。凭借增强的提示理解和上下文意识,它在复杂对话、创意写作和高级内容创作中表现卓越。非常适合需要深入参与和高质量输出的应用场景。
- Cohere embed-multilingual-v2.0: 这个模型专注于生成高质量的多语言嵌入,使得有效的跨语言理解和检索成为可能。它的优势在于捕捉多种语言中的语义关系,因此非常适合用于多语言搜索、推荐系统以及全球内容分析等应用,在这些领域中语言多样性是一个重要因素。
完成本教程后,你将拥有一个能够基于自定义知识库回答问题的完整聊天机器人。
注意事项: 使用专有模型前请确保已获取有效 API 密钥。
实战:搭建 RAG 聊天机器人
第 1 步:安装并配置 LangChain
%pip install --quiet --upgrade langchain-text-splitters langchain-community langgraph
第 2 步:安装并配置 Anthropic Claude 3.5 Sonnet
pip install -qU "langchain[anthropic]"
import getpass
import os

if not os.environ.get("ANTHROPIC_API_KEY"):
  os.environ["ANTHROPIC_API_KEY"] = getpass.getpass("Enter API key for Anthropic: ")

from langchain.chat_models import init_chat_model

llm = init_chat_model("claude-3-5-sonnet-latest", model_provider="anthropic")
第 3 步:安装并配置 Cohere embed-multilingual-v2.0
pip install -qU langchain-cohere
import getpass
import os

if not os.environ.get("COHERE_API_KEY"):
  os.environ["COHERE_API_KEY"] = getpass.getpass("Enter API key for Cohere: ")

from langchain_cohere import CohereEmbeddings

embeddings = CohereEmbeddings(model="embed-multilingual-v2.0")
第 4 步:安装并配置 Milvus
pip install -qU langchain-milvus
from langchain_milvus import Milvus

vector_store = Milvus(embedding_function=embeddings)
第 5 步:正式构建 RAG 聊天机器人
在设置好所有组件之后,我们来搭建一个简单的聊天机器人。我们将使用 Milvus介绍文档 作为私有知识库。你可以用你自己的数据集替换它,来定制你自己的 RAG 聊天机器人。
import bs4
from langchain import hub
from langchain_community.document_loaders import WebBaseLoader
from langchain_core.documents import Document
from langchain_text_splitters import RecursiveCharacterTextSplitter
from langgraph.graph import START, StateGraph
from typing_extensions import List, TypedDict

# 加载并拆分博客内容
loader = WebBaseLoader(
    web_paths=("https://milvus.io/docs/overview.md",),
    bs_kwargs=dict(
        parse_only=bs4.SoupStrainer(
            class_=("doc-style doc-post-content")
        )
    ),
)

docs = loader.load()

text_splitter = RecursiveCharacterTextSplitter(chunk_size=1000, chunk_overlap=200)
all_splits = text_splitter.split_documents(docs)

# 索引分块
_ = vector_store.add_documents(documents=all_splits)

# Define prompt for question-answering
prompt = hub.pull("rlm/rag-prompt")


# 定义应用状态
class State(TypedDict):
    question: str
    context: List[Document]
    answer: str


# 定义应用步骤
def retrieve(state: State):
    retrieved_docs = vector_store.similarity_search(state["question"])
    return {"context": retrieved_docs}


def generate(state: State):
    docs_content = "\n\n".join(doc.page_content for doc in state["context"])
    messages = prompt.invoke({"question": state["question"], "context": docs_content})
    response = llm.invoke(messages)
    return {"answer": response.content}


# 编译应用并测试
graph_builder = StateGraph(State).add_sequence([retrieve, generate])
graph_builder.add_edge(START, "retrieve")
graph = graph_builder.compile()
测试聊天机器人
Yeah! You've built your own chatbot. Let's ask the chatbot a question.
response = graph.invoke({"question": "What data types does Milvus support?"})
print(response["answer"])
示例输出
Milvus 支持多种数据类型,包括稀疏向量、二进制向量、JSON 和数组。此外,它还支持常见的数值类型和字符类型,使其能够满足不同的数据建模需求。这使得用户能够高效地管理非结构化或多模态数据。
优化小贴士
在搭建 RAG 系统时,合理调优能显著提升性能与效率。下面为各组件提供一些实用建议:
LangChain 优化建议
为了优化 LangChain,需要通过高效地构建链路和代理来减少工作流程中的冗余操作。使用缓存避免重复计算,从而加快系统速度,并尝试采用模块化设计,确保模型或数据库等组件能够轻松替换。这将提供灵活性和效率,使您能够快速扩展系统,而无需不必要的延迟或复杂性。
Milvus 优化建议
Milvus 作为一个高效的向量数据库,在 RAG 系统的检索任务中发挥着关键作用。要优化其性能,应确保构建合适的索引,以平衡速度和准确性;对于响应时间至关重要的场景,可考虑使用 HNSW(Hierarchical Navigable Small World)进行高效的最近邻搜索。根据使用模式对数据进行分区,有助于提升查询性能并减少加载时间,从而提高系统的可扩展性。根据查询频率定期监控并调整缓存设置,以避免数据检索时出现延迟。向量插入时采用批处理模式,可以减少数据库锁争用,提高整体吞吐量。此外,通过调整向量的维度来优化模型参数:更高的维度可以提升检索准确性,但可能增加搜索时间,因此需根据具体用例和硬件条件找到最佳平衡点。
Anthropic Claude 3.5 Sonnet 优化建议
Claude 3.5 Sonnet 提供了增强的推理能力,同时在速度和复杂性之间保持平衡。通过优化检索管道来优先考虑排名最高的上下文,减少不必要的令牌消耗。使用自适应切块方法提供结构化和简洁的上下文,确保模型只接收最相关的信息。实施动态查询选择方法,将简单的问题路由到 Claude 3.5 Haiku,以提高成本和速度效率,同时将 Sonnet 保留用于更深层次的推理。通过批处理和响应缓存来优化 API 请求处理,以降低延迟。微调温度和采样设置,对于基于检索的任务保持较低,以实现确定性的输出。使用系统指令来指导响应,改善一致性并减少幻觉。如果大规模部署,利用并行查询执行和实时监控,根据系统性能指标动态调整工作负载。
Cohere embed-multilingual-v2.0 优化建议
Cohere embed-multilingual-v2.0支持多种语言,使其成为跨语言RAG设置的理想选择。为了优化效率,预处理文本以去除特定语言的噪声并处理编码问题,确保为嵌入生成提供干净的输入。实施高效的ANN算法,如采用层次索引的FAISS,以支持在多语言数据集中的快速检索。使用产品量化或HNSW等技术压缩嵌入,以优化存储和速度。使用语言检测模型将查询路由到相应的语言特定嵌入,减少不必要的计算。批量处理嵌入操作,并利用并行处理来高效处理大量多语言数据。定期更新嵌入,以确保模型反映任何语言变化或发展趋势。
通过系统性实施这些优化方案,RAG 系统将在响应速度、结果准确率、资源利用率等维度获得全面提升。 AI 技术迭代迅速,建议定期进行压力测试与架构调优,持续跟踪最新优化方案,确保系统在技术发展中始终保持竞争优势。
RAG 成本计算器
估算 RAG 成本时,需要分析向量存储、计算资源和 API 使用等方面的开销。主要成本驱动因素包括向量数据库查询、嵌入生成和 LLM 推理。RAG 成本计算器是一款免费的在线工具,可快速估算构建 RAG 的费用,涵盖切块(chunking)、嵌入、向量存储/搜索和 LLM 生成。能帮助你发现节省费用的机会,最高可通过无服务器方案在向量存储成本上实现 10 倍降本。
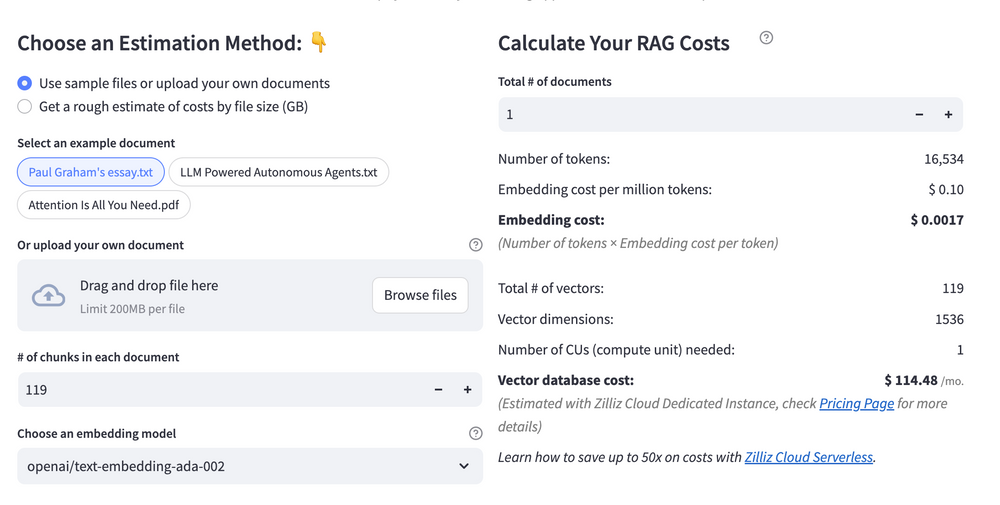 Calculate your RAG cost
收获与总结
你学到了什么?
恭喜你完成了这个激动人心的教程!你刚刚迈出了信息检索未来的重要一步,学习了如何整合关键组件,如强大的框架、高性能的向量数据库、前沿的LLM和优秀的嵌入模型,以发掘RAG系统的真正潜力。通过这段旅程,你亲眼见证了框架如何将一切连接在一起,创建出无缝的工作流程,让每个组件都能发挥其最佳效果。
向量数据库Milvus使快速高效的搜索成为可能,改变了你探索庞大数据集的方式。你亲自发现,LLM Anthropic Claude 3.5 Sonnet如何将对话智能融入其中,让你的互动感受更加自然和吸引人。此外,嵌入模型Cohere的embed-multilingual-v2.0为你提供了生成丰富语义表示的工具,确保你的查询返回最相关的结果。
我们还提供了一些实用的优化技巧和免费的成本计算器,帮助你在开展项目时更加顺利。可能性是无穷的,你拥有了一切所需,开始构建、优化和创新你自己的RAG应用程序。所以不要等待,快去创造令人惊叹的东西吧!你在先进AI解决方案世界的旅程现在开始!
欢迎反馈!
我们很期待听到你的使用心得与建议! 🌟 你可以:
- 在下方留言;
- 加入 Milvus Discord 社区,与全球 AI 爱好者一起交流。 如果你觉得本教程对你有帮助,别忘了给 Milvus GitHub 仓库点个 ⭐,这将激励我们不断创作!💖