使用 LangChain、Milvus、Mistral AI Codestral Mamba 和 Azure text-embedding-3-large 构建 RAG 聊天机器人
什么是 RAG
检索增强生成(Retrieval-Augmented Generation,简称 RAG)正引领生成式 AI,尤其是对话式 AI 的新潮流。它将预训练的大语言模型(LLM,如 OpenAI 的 GPT)与存储于向量数据库(如 Milvus、Zilliz Cloud)中的外部知识源相结合,从而让模型输出更准确、更具上下文相关性,并且能够及时融合最新信息。 一个完整的 RAG 系统通常包含以下四大核心组件:
- 向量数据库:用于存储与检索向量化后的知识;
- 嵌入模型:将文本转为向量表示,为后续的相似度搜索提供支持;
- 大语言模型(LLM):根据检索到的上下文和用户提问生成回答;
- 框架:负责将上述组件串联成可用的应用。
核心组件说明
本教程将带你在 Python 环境下,借助以下组件一步步搭建一个初级的 RAG 聊天机器人:
- LangChain: 一个开源框架,帮助你协调大语言模型、向量数据库、嵌入模型等之间的交互,使集成检索增强生成(RAG)管道变得更容易。
- Milvus: 一个开源的向量数据库,专门用于高效地存储、索引和搜索大规模向量嵌入,非常适合用于检索增强生成(RAG)、语义搜索和推荐系统等场景。如果您需要更具扩展性的解决方案,或不想管理自己的基础设施,我们推荐使用 Zilliz Cloud,这是一个基于开源项目 Milvus构建的全托管向量数据库服务,并提供支持最多 100 万个向量的免费套餐。
- Mistral AI Codestral Mamba: Codestral Mamba是一款高性能的编码助手,旨在提升软件开发效率。它在生成和调试多种编程语言的代码方面表现出色。凭借对编程环境和常用库的深刻理解,它非常适合寻求快速原型开发、代码优化和重构支持的开发者。
- Azure text-embedding-3-large: 这个强大的AI模型专注于为自然语言处理任务生成高质量的文本嵌入。凭借其对上下文的高级理解,它在语义搜索、推荐系统和聚类等应用中表现出色。非常适合那些希望提升复杂数据集中文本分析和检索的开发者,同时确保强大的准确性和性能。
完成本教程后,你将拥有一个能够基于自定义知识库回答问题的完整聊天机器人。
注意事项: 使用专有模型前请确保已获取有效 API 密钥。
实战:搭建 RAG 聊天机器人
第 1 步:安装并配置 LangChain
%pip install --quiet --upgrade langchain-text-splitters langchain-community langgraph
第 2 步:安装并配置 Mistral AI Codestral Mamba
pip install -qU "langchain[mistralai]"
import getpass
import os

if not os.environ.get("MISTRAL_API_KEY"):
  os.environ["MISTRAL_API_KEY"] = getpass.getpass("Enter API key for Mistral AI: ")

from langchain.chat_models import init_chat_model

llm = init_chat_model("open-codestral-mamba", model_provider="mistralai")
第 3 步:安装并配置 Azure text-embedding-3-large
pip install -qU langchain-openai
import getpass
import os

if not os.environ.get("AZURE_OPENAI_API_KEY"):
  os.environ["AZURE_OPENAI_API_KEY"] = getpass.getpass("Enter API key for Azure: ")

from langchain_openai import AzureOpenAIEmbeddings

embeddings = AzureOpenAIEmbeddings(
    azure_endpoint=os.environ["AZURE_OPENAI_ENDPOINT"],
    azure_deployment=os.environ["AZURE_OPENAI_DEPLOYMENT_NAME"],
    openai_api_version=os.environ["AZURE_OPENAI_API_VERSION"],
)
第 4 步:安装并配置 Milvus
pip install -qU langchain-milvus
from langchain_milvus import Milvus

vector_store = Milvus(embedding_function=embeddings)
第 5 步:正式构建 RAG 聊天机器人
在设置好所有组件之后,我们来搭建一个简单的聊天机器人。我们将使用 Milvus介绍文档 作为私有知识库。你可以用你自己的数据集替换它,来定制你自己的 RAG 聊天机器人。
import bs4
from langchain import hub
from langchain_community.document_loaders import WebBaseLoader
from langchain_core.documents import Document
from langchain_text_splitters import RecursiveCharacterTextSplitter
from langgraph.graph import START, StateGraph
from typing_extensions import List, TypedDict

# 加载并拆分博客内容
loader = WebBaseLoader(
    web_paths=("https://milvus.io/docs/overview.md",),
    bs_kwargs=dict(
        parse_only=bs4.SoupStrainer(
            class_=("doc-style doc-post-content")
        )
    ),
)

docs = loader.load()

text_splitter = RecursiveCharacterTextSplitter(chunk_size=1000, chunk_overlap=200)
all_splits = text_splitter.split_documents(docs)

# 索引分块
_ = vector_store.add_documents(documents=all_splits)

# Define prompt for question-answering
prompt = hub.pull("rlm/rag-prompt")


# 定义应用状态
class State(TypedDict):
    question: str
    context: List[Document]
    answer: str


# 定义应用步骤
def retrieve(state: State):
    retrieved_docs = vector_store.similarity_search(state["question"])
    return {"context": retrieved_docs}


def generate(state: State):
    docs_content = "\n\n".join(doc.page_content for doc in state["context"])
    messages = prompt.invoke({"question": state["question"], "context": docs_content})
    response = llm.invoke(messages)
    return {"answer": response.content}


# 编译应用并测试
graph_builder = StateGraph(State).add_sequence([retrieve, generate])
graph_builder.add_edge(START, "retrieve")
graph = graph_builder.compile()
测试聊天机器人
Yeah! You've built your own chatbot. Let's ask the chatbot a question.
response = graph.invoke({"question": "What data types does Milvus support?"})
print(response["answer"])
示例输出
Milvus 支持多种数据类型,包括稀疏向量、二进制向量、JSON 和数组。此外,它还支持常见的数值类型和字符类型,使其能够满足不同的数据建模需求。这使得用户能够高效地管理非结构化或多模态数据。
优化小贴士
在搭建 RAG 系统时,合理调优能显著提升性能与效率。下面为各组件提供一些实用建议:
LangChain 优化建议
为了优化 LangChain,需要通过高效地构建链路和代理来减少工作流程中的冗余操作。使用缓存避免重复计算,从而加快系统速度,并尝试采用模块化设计,确保模型或数据库等组件能够轻松替换。这将提供灵活性和效率,使您能够快速扩展系统,而无需不必要的延迟或复杂性。
Milvus 优化建议
Milvus 作为一个高效的向量数据库,在 RAG 系统的检索任务中发挥着关键作用。要优化其性能,应确保构建合适的索引,以平衡速度和准确性;对于响应时间至关重要的场景,可考虑使用 HNSW(Hierarchical Navigable Small World)进行高效的最近邻搜索。根据使用模式对数据进行分区,有助于提升查询性能并减少加载时间,从而提高系统的可扩展性。根据查询频率定期监控并调整缓存设置,以避免数据检索时出现延迟。向量插入时采用批处理模式,可以减少数据库锁争用,提高整体吞吐量。此外,通过调整向量的维度来优化模型参数:更高的维度可以提升检索准确性,但可能增加搜索时间,因此需根据具体用例和硬件条件找到最佳平衡点。
Mistral AI Codestral Mamba 优化建议
Codestral Mamba 针对代码生成和补全进行了优化,非常适合涉及结构化编程查询的 RAG 应用。通过使用在代码数据集上训练的嵌入,提高检索质量,以确保检索到的上下文与编程语言和任务良好对齐。为了增强响应的准确性,确保输入提示格式清晰,包含函数定义、文档字符串和注释。动态调整温度值——较低的值(0.1–0.2)用于确定性代码生成,较高的值(0.3–0.5)用于探索性建议。使用缓存来存储常见的编程模式和频繁查询的代码片段,以减少延迟。如果在 IDE 或交互式编码环境中部署,请启用流式传输,以提供实时反馈和建议。在处理多个同时的代码查询时,利用并行推理技术来优化性能。
Azure text-embedding-3-large 优化建议
Azure text-embedding-3-large 是一个强大的模型,用于生成高质量的文本嵌入。通过预处理输入文本以去除冗余内容,优化效率,并确保嵌入集中于最重要的概念。利用近似最近邻(ANN)搜索算法,如 FAISS 或 HNSW,在大数据集中快速检索。处理高吞吐量应用时,实行缓存策略以存储经常访问的嵌入,减少 API 调用开销。使用多线程或并行处理来处理批量请求,降低大规模系统的延迟。考虑使用降维技术,如 PCA 或量化,来减少存储需求并提高检索速度。定期更新嵌入以反映新数据,确保系统的搜索结果准确。
通过系统性实施这些优化方案,RAG 系统将在响应速度、结果准确率、资源利用率等维度获得全面提升。 AI 技术迭代迅速,建议定期进行压力测试与架构调优,持续跟踪最新优化方案,确保系统在技术发展中始终保持竞争优势。
RAG 成本计算器
估算 RAG 成本时,需要分析向量存储、计算资源和 API 使用等方面的开销。主要成本驱动因素包括向量数据库查询、嵌入生成和 LLM 推理。RAG 成本计算器是一款免费的在线工具,可快速估算构建 RAG 的费用,涵盖切块(chunking)、嵌入、向量存储/搜索和 LLM 生成。能帮助你发现节省费用的机会,最高可通过无服务器方案在向量存储成本上实现 10 倍降本。
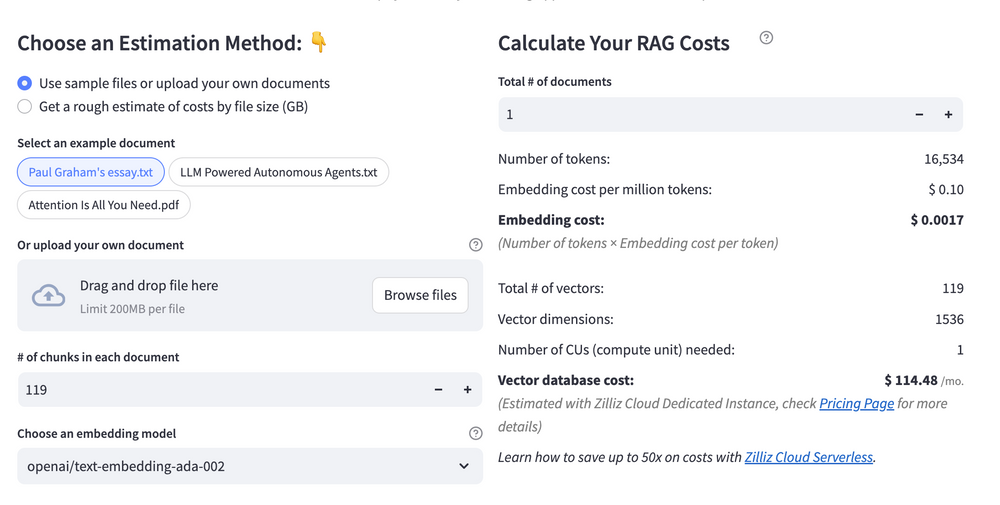 Calculate your RAG cost
收获与总结
“我们在这个教程中共同经历了多么令人难以置信的旅程!你刚刚探索了一个框架、一个向量数据库、一个大型语言模型(LLM)和一个嵌入模型的强大集成,创造了一个最先进的检索增强生成(RAG)系统。这难道不让人兴奋吗?每个组件都发挥着关键作用:框架无缝地将一切联系在一起,使你能够轻松编排复杂的工作流程;向量数据库,比如 Milvus,使得搜索速度如闪电般快速,确保相关信息触手可及;LLM,比如 Mistral AI Codestral Mamba,为你的应用注入了自然且引人入胜的对话智能;最后,嵌入模型,例如 Azure 的 text-embedding-3-large,生成深层语义表示,以提升你的交互质量。
我们还深入探讨了一些巧妙的优化技巧,甚至探索了一个方便的成本计算器,以帮助你在构建和扩展项目时管理开支。希望这个教程能够激发你的创造力,打开你对未来无尽可能性的思维。不要止步于此——将你所学到的运用到实践中,开始构建、优化和创新你自己的 RAG 应用程序!深入探索,进行实验,让你的创造力自由流淌。天空才是极限,我迫不及待想看到你接下来提出的精彩解决方案!”
欢迎反馈!
我们很期待听到你的使用心得与建议! 🌟 你可以:
- 在下方留言;
- 加入 Milvus Discord 社区,与全球 AI 爱好者一起交流。 如果你觉得本教程对你有帮助,别忘了给 Milvus GitHub 仓库点个 ⭐,这将激励我们不断创作!💖