模型训练中,如何低成本筛选large top-k数据
过去,无论做推荐、语义搜索还是知识库,大多数向量检索系统都会默认:用户只需要最相似的少量结果。TopK 通常只有不到十个,或者最多几十、几百。
但AI时代,需求变了。
在训练数据构建、多模态数据分析和大规模数据管理等AI workload中,大topk查询变得非常的常见。与此同时,在电商场景中,把一个商品推荐弹窗,则需要从千万已经标签筛过滤的用户中,再筛出几十万量级的topk精准用户。
而当 K 从 10、100 增长到 10,000、100,000 甚至更高时,系统的主要开销会随之改变:一方面,搜索算法需要访问更大的向量邻域,增加计算成本之外,大量向量距离计算会受到内存带宽限制;另一方面,分布式节点需要返回和合并更多中间结果,候选结果的维护成本也会快速增加;
今天这篇文章,我们主要聊聊,large top-k需求下,我们是如何做索引结构和执行引擎优化的。
01
AI workload,带来了向量检索的large top-k需求
典型的大TopK场景,主要集中于各种AI workload,包括但不限于:
1. 训练数据检索与数据集构建
假设一个多模态训练平台维护着数十亿甚至上百亿条图片 embedding,用于 Text-to-Image 或视觉模型开发。
开发者输入一个文本 prompt 或一组参考图片后,希望一次检索 10^4-10^5 张相关图片,用来构建特定领域的微调数据集或者寻找长尾类别中的相关数据。
这里的目标是获得一个规模足够大的相关样本集合。只返回几十个结果,无法支撑后续的数据处理流程。
2. 训练数据质量与分布分析
Large top-k 也常用于分析训练数据的质量和分布。例如,团队可能希望回答以下问题:与某个文本概念相关的数据有多少?某个视觉类别在训练集中是否覆盖充分?检索结果是否集中在少数来源、风格或时间段?不同数据集之间是否存在大量重复或高度相似的样本?
这些任务中,如果只观察很小的 TopK,分析结果很容易被最相似的一小部分样本主导,无法反映更完整的数据分布。
3. LLM / 多模态数据管理
在 LLM data management、multimodal data analytics 和训练数据资产管理中,向量检索经常只是处理流程的第一步。
一个生产集群可能管理约 100 TB 数据和数十亿条 image embeddings,并支持 Top-100,000 级别的检索。返回的结果通常不会直接展示给终端用户,而是继续进入后续的数据处理流程,例如:
SQL 过滤与聚合;元数据分析;数据质量检测;样本发现;数据集导出与构建。
这与在线问答或普通图片搜索有明显区别。后者只需要返回少量结果,而数据管理系统需要把一大批相关数据高效地交给下游任务。
4. 探索式相似性分析
Large top-k 的另一个典型使用方式,是先检索一个较大的相似邻域,再从中寻找规律。
研究人员可能先获取数十万个相关向量,然后继续执行:分组和聚类;属性分布分析;条件过滤;Join;异常值检测;人工抽样与审核。
因此,这类查询通常更关注候选集规模、吞吐量和整体处理效率,而不只是单次查询能否在几毫秒内完成。
02
Graph is all you need? No!
图索引(如HNSW等)在绝大多数常规向量检索场景下,表现出极高的搜索效率,主要得益于其巧妙利用了“小世界”网络特性和贪心路由机制。
具体来说,图索引构建了具有“小世界”拓扑结构的网络,这种结构同时包含用于局部精细搜索的短跳边和用于跨区域快速跳转的长跳边,使得算法能够在极其庞大的数据集中通过极少的步数(搜索时间复杂度通常可逼近O(log N))快速逼近目标向量所在的大致区域,这类似于人类社会中的“六度空间理论”。
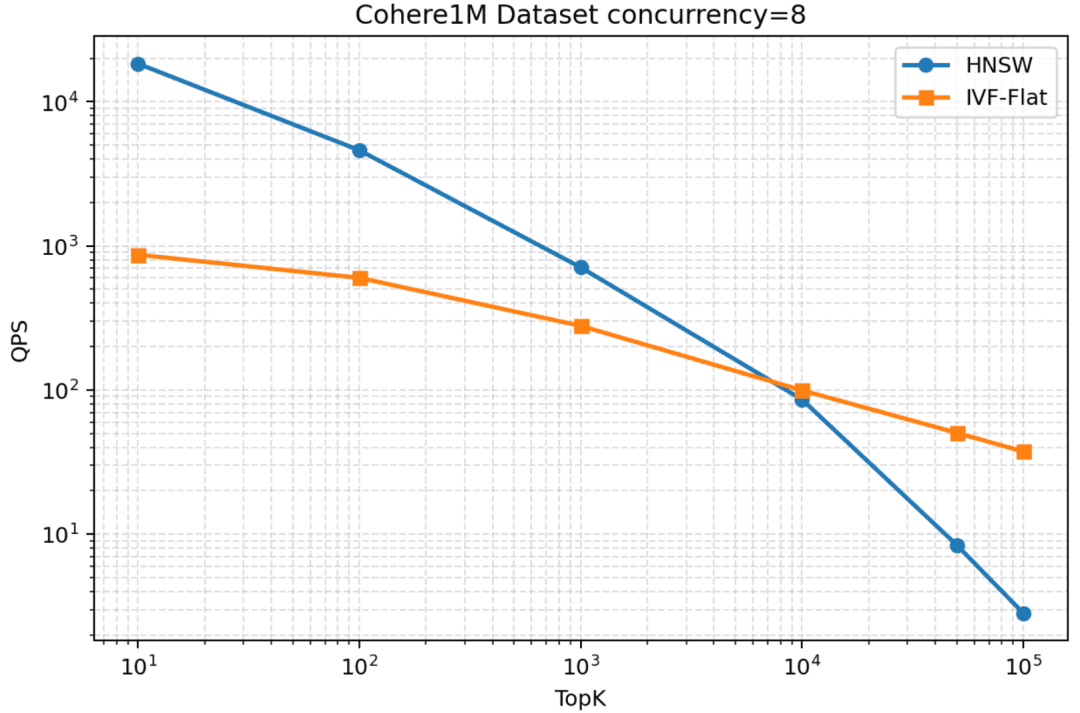
但是在面对大Topk查询的时候,图索引的性能会显著变差,有以下几个原因:
贪心搜索退化:图索引依赖贪心路由快速逼近局部最优解,适合寻找极其相近的少数点,当K值很大时,搜索范围被迫急剧扩大,算法需要遍历大量的节点。图索引依靠少量跳转完成搜索的优势会明显下降。
优先队列维护成本剧增:对于每个新访问的节点,系统需要计算其距离,并根据距离更新优先队列。较小的 K 值下,这些队列规模有限,插入、弹出和调整堆结构的成本通常可以接受。Large top-k 查询中,结果集合可能包含数万甚至数十万个元素。随着 K 增大:优先队列占用更多内存;每个候选结果都可能触发堆调整;大量插入和弹出操作消耗更多 CPU;数据结构维护开始占据显著的查询时间。
随机访存的劣势放大:图索引中的节点及其邻接关系通常分布在不同内存位置。搜索过程需要沿着图边不断跳转,因此会产生大量随机内存访问。当访问节点数量较少时,这个问题并不突出。但 large top-k 需要遍历更多节点,cache miss 和内存访问延迟会被持续放大。最终,查询性能可能不再受计算能力限制,而是受到内存带宽和缓存效率限制。
所以在处理大topk查询时,基于倒排的索引IVF是一个更好的选择,它的优势主要体现在两方面。
内存连续存储,局部性好:IVF通过K-Means等算法将整个高维向量空间划分为多个聚类簇(Voronoi单元)。同一个簇内的向量数据在物理内存中是紧凑且连续存储的。在进行大范围搜索时,IVF执行的是顺序内存读取,这极大地提高了cache的命中率,避免图索引因离散节点遍历引发的内存带宽瓶颈。
硬件指令集加速更友好:大topk查询本质上需要对比海量的候选向量,IVF连续存储的特性使其完美契合现代CPU的SIMD指令集(如AVX-512)或者GPU的大规模矩阵运算核心。
将导航和扫描分开:IVF 先通过聚类中心缩小搜索范围,再对选中的列表进行批量扫描。这种结构把查询分成两个阶段:先判断哪些区域值得搜索;再高效扫描这些区域中的候选向量。当 K 较大时,第二阶段的扫描成本会成为主要开销。IVF 可以在这一阶段充分利用连续存储和向量化计算,因此比图遍历更容易获得稳定的吞吐量。
03
Reservoir, not priority queue
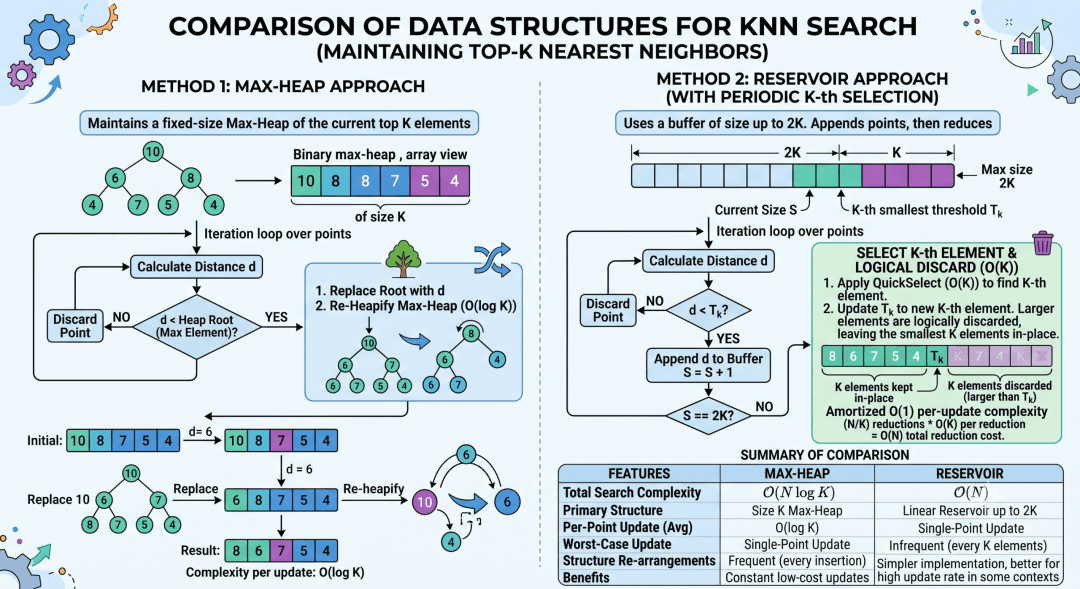
前面提到在图索引中,优先队列在处理大topk查询的时候会成为性能瓶颈,在这一点上IVF索引也无法避免,因为无论使用什么索引,只要系统需要从大量候选向量中返回距离最近的 K 个结果,就需要维护一个候选结果集合。
传统方法通常使用大小为 K 的优先队列。对于每个新候选:
如果结果数量不足 K,则插入队列;
如果新候选优于当前最差结果,则插入新结果;
弹出当前最差结果;
重新调整堆结构。
当 K 很大时,这一流程可能被执行数百万次。即使单次操作复杂度不高,累计成本仍然非常可观。
但Large top-k 并不要求系统在扫描过程中始终维护一个严格有序的 TopK 集合。只要扫描结束时能够准确选出最优的 K 个结果,中间状态可以更加宽松。
所以可以通过Reservoir的方式,把存储结果的数据结构设置成比topk要大的一个结构。
然后在搜索过程中,比当前第k大元素(请注意这不是严格的)小的结果,直接append到结果中,而不是像操作优先队列一样需要做队列结构的调整,而只当数据规模达到Reservoir的capacity以后再选出当前状态的第k大元素即可。
这样就可以把大量细粒度的堆操作,转换成次数更少的批量筛选操作。
K 越大,这种批量维护方式相对于传统优先队列的优势通常越明显。
04
AutoIndex 如何优化分布式 large top-k 查询
Large top-k带来的挑战不仅在于索引的选型上,还在于查询模式的重构。
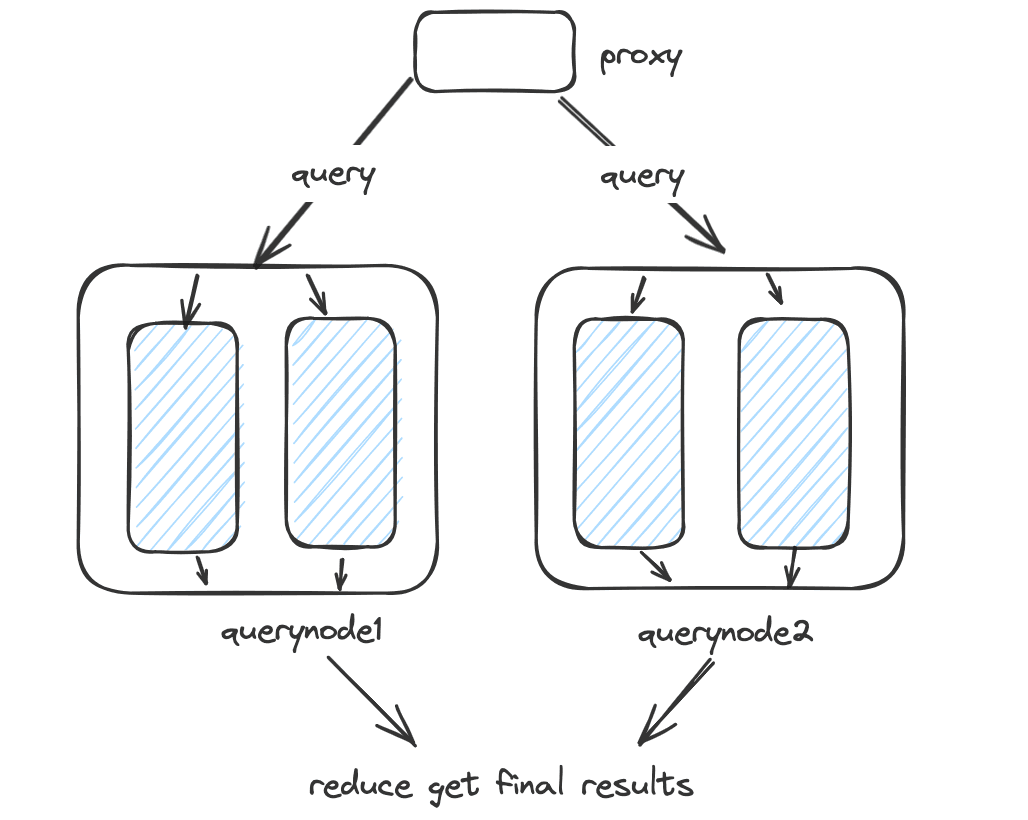
Milvus的架构可以认为是一个分布式的scatter-gather的模式。Proxy 会把查询分发到多个 QueryNode,每个 QueryNode 搜索自己负责的 Segment,执行本地TopK检索,并返回本地候选结果。系统随后对所有节点返回的候选进行合并,得到最终 TopK。
对于较小的 K,这种流程效果不错。
但在大top K场景中,如果每个 Segment 都机械地执行一次完整的 large top-k 查询,成本会被显著放大。更关键的是,不同 Segment 对最终结果的贡献通常并不相同。如果对所有 Segment 分配相同的检索预算,就会在低贡献 Segment 上浪费大量计算。
为了解决这类问题,Zilliz Cloud 中,我们推出了 AutoIndex。这是一个基于机器学习和运行时统计信息的优化器,用于在召回率和查询性能之间选择更合适的执行参数。
当处理 large top-k 查询时,AutoIndex可以通过统计信息分析每个segment对结果的贡献程度,为它们分配不同的检索预算。
这意味着系统不必要求每个 Segment 都返回同样规模的本地 TopK。高贡献 Segment 可以返回更多候选,低贡献 Segment 则可以减少搜索范围和结果数量。在维持目标召回率的前提下,这种方式可以同时减少:
Segment 内部的索引搜索开销;
QueryNode 返回的中间结果数量;
节点之间的数据传输;
全局结果归并的计算压力。
尾声
总结来说,优化large top-k 成本,一共分为三步:
算法层:使用更适合批量扫描的 IVF
执行层:使用 Reservoir 降低结果维护成本
分布式层:使用 AutoIndex 控制 Segment 查询预算
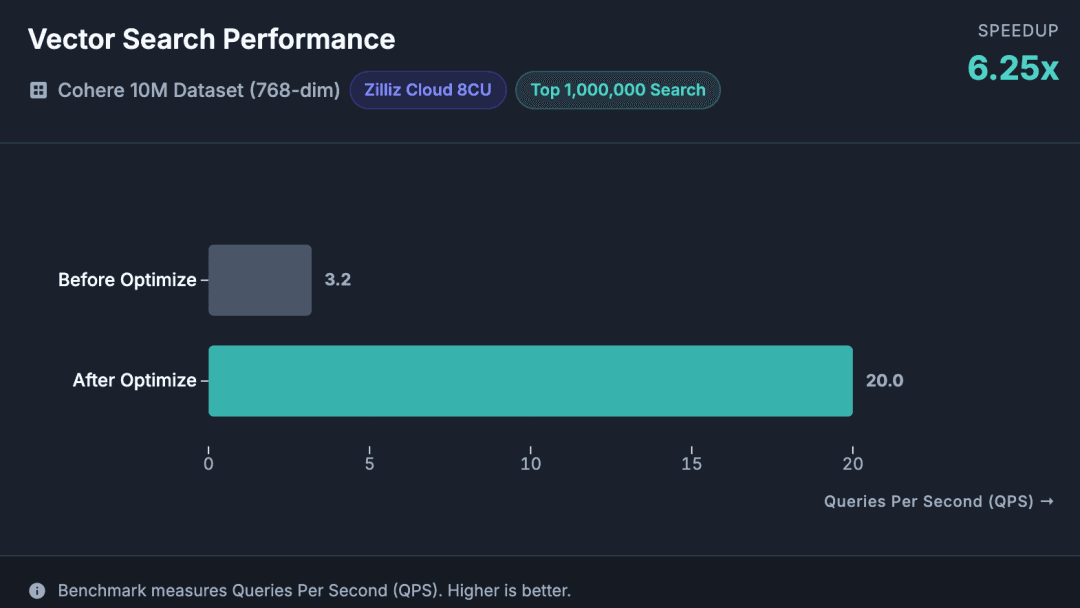
最后,把这些优化汇总起来,我们可以得到优化的性能结果如下。
附:Zilliz Cloud中如何使用large topk
Zilliz Cloud 默认的 TopK 上限为 16,384。对于需要返回更多结果的 workload,可以为 Collection 启用 large_topk 查询模式。启用后,单次向量查询最高可以支持 Top-1,000,000。
创建 Collection 时,可以通过 properties 设置查询模式:
client.create_collection(
    collection_name="test",
    schema=schema,
    num_partitions=1,
    properties={"query_mode": "large_topk"})
对于已经创建的 Collection,也可以通过修改 Collection properties 开启:
client.alter_collection_properties(
    collection_name="scenarios_corpus",
    properties={"query_mode": "large_topk"}
)
 高超