EverOS接入Milvus 实测:这个1.2 万 Star 的Memory 项目,有哪些值得学习的地方?
EverOS 是 EverMind-AI 开源的 Agent 长期记忆系统。
它今年 6 月 3 日才发布 1.0.0,到 9 月已经拿到约 12.8K GitHub Stars、900 多个 Fork;并且与 DeepSeek Harness、Hermes、OpenClaw、Dify 等 Agent 或 workflow 做了集成。
在本篇文章中,我们会拆解这个公开发布只有三个多月的 Agent Memory 明星项目究竟是如何设计的,并给出如何将 Milvus 与 EverOS 做深度结合的手把手教程。
01
EverOS是什么?它如何定义记忆
作为一个典型的 Agent Memory 项目,EverOS 可以接收 Agent 的 conversation、文件和执行轨迹,把这些原始信息加工成可以长期保存和复用的记忆。
在用户记忆这一侧,它会把信息拆成不同粒度:Episode 保留一次完整经历和上下文,Atomic Fact 从这些经历里抽出更稳定、可复用的事实,Profile 再根据持续积累的事实更新用户的长期状态。比如一次对话里提到“工作日告警 15 分钟内确认”,这件事既可以留在当天的 Episode 里,也可以被抽成一条独立事实;如果类似信息持续出现,还可以进一步进入 Profile。
Agent 自己的经验方面。一次完成任务的执行轨迹可以被整理成 Case,记录任务、做法和结果;多个相似 Case 积累以后,还可以继续归纳成 Skill,让 Agent 后面碰到类似任务时复用已经验证过的方法。
也就是说,用户记忆在从Episode → Fact → Profile演化,把具体经历逐渐沉淀成长期状态;Agent 经验则从Trajectory → Case → Skill演化,把一次执行逐渐沉淀成可复用的方法。
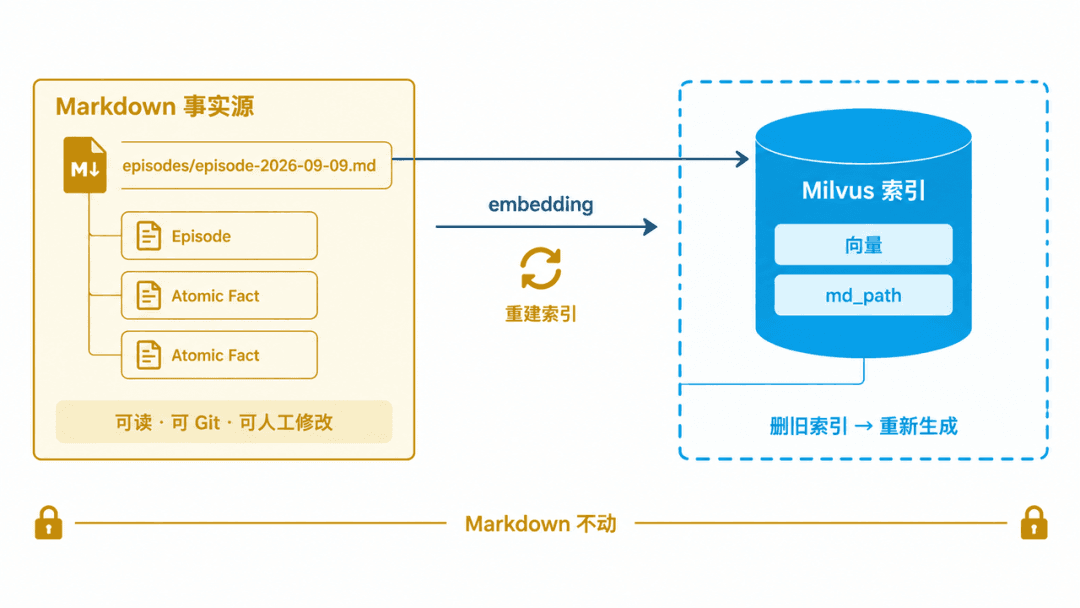
在数据的存储上。EverOS中本地默认有三个存储层:Markdown 保存 memory content,是 source of truth;SQLite 保存系统状态和队列;检索数据库保存 vector、BM25 和标量索引。后两层都可以从 Markdown 重建。其中只有 Markdown 是 source of truth。SQLite 和 LanceDB 都被官方定义成 derived、rebuildable state。把整个 .index/ 目录删掉,Markdown 还在,系统可以根据这些文件重新建立状态和检索索引。
搜索时,EverOS 则会再根据当前问题,从这些不同类型的记忆里做 keyword、vector 或 hybrid retrieval。
借助这样一套链路,即使 Agent 记错用户偏好,或者某些信息后续失效,我们也可以直接在原始 Markdown 文档中修改,然后在 entry 粒度做 diff。不用研究数据库中的内部数据结构,再对其做解码。
即使后续需要切换后端的向量数据库。比如从 LanceDB 换到 Milvus,EverOS 也不需要重新生成记忆本身。Episode、Atomic Fact、User Profile 这些已经经过 LLM 抽取和整理的记忆结果都保存在 Markdown 里;EverOS 只需要重新读取这些 Markdown、计算 embedding,再在新的向量库里重建索引。
02
怎么在EverOS 中接入 Milvus
本章节,我们将测试如何在 EverOS 中接入 Milvus。
我们选择的测试环境是 Python 3.12+、EverOS 1.3.1、远程 Milvus 2.6.23(EverOS已经支持接入远程 Milvus Server 或 Zilliz Cloud;本地 Lite 会直接被拒绝),本地使用一个 1024 维 embedding model,再配一个负责 memory extraction 的 LLM。
安装与配置:
pip install ".[milvus]" # 在 EverOS 仓库、Python ≥ 3.12 环境下运行;确认 pymilvus 一并装上
[index]
backend = "milvus"
[milvus]
uri = "http://<host>:19530"  # 或填写 Zilliz Cloud endpoint
token = "***"                 # 使用 Zilliz Cloud 时填写 API key
consistency_level = "Session"
collection_prefix = "everos_exp"
[embedding]
model = ""
base_url = "http://127.0.0.1:11434/v1"
[llm]
model = ""
base_url = "/v1"
接下来依次执行:写入 -> flush -> 检索curl
curl -X POST /api/v1/memory/add -d @messages.json  # 10 条可核对消息
curl -X POST /api/v1/memory/flush
curl -X POST /api/v2/memory/search -d '{"query":"...","method":"hybrid","top_k":3}'
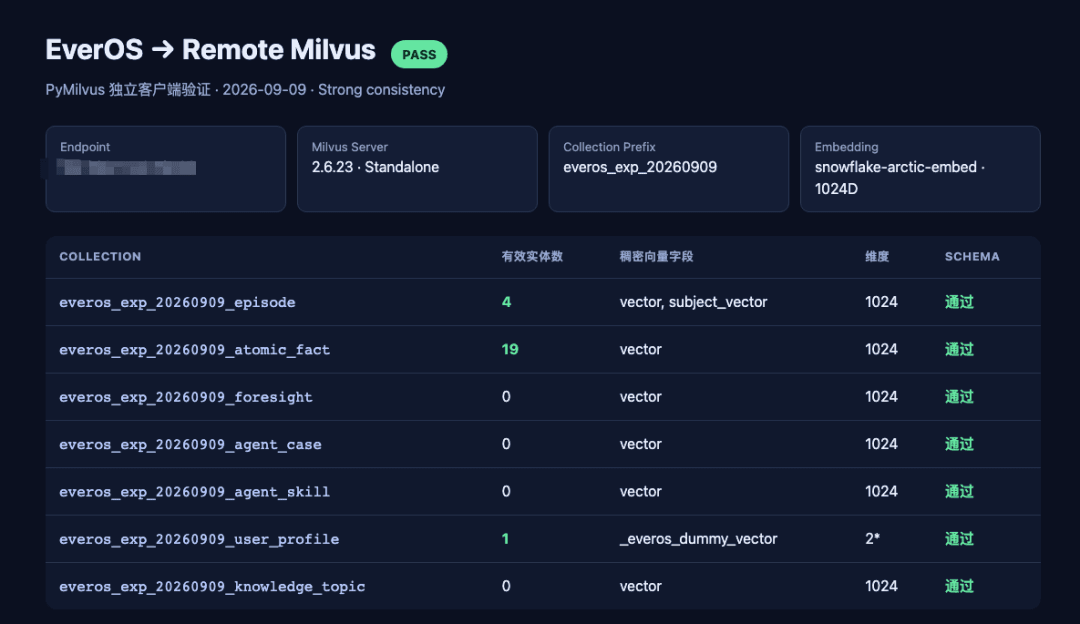
服务启动后,EverOS 会连接远程 Milvus,并按照不同的 memory kind 初始化对应的 Collection。本次一共创建了 7 张 _ Collection,对应 Episode、Atomic Fact、User Profile、Foresight、Agent Case、Agent Skill 和 Knowledge Topic。
接下来,我们准备了 10 条人工构造、可以直接核对结果的测试消息,其中包括前面提到的值班规则:“工作日告警 15 分钟内确认,周末响应时限是 30 分钟。”
把这批消息写进 EverOS,再执行 flush:
然后执行完整链路:
curl -X POST /api/v1/memory/add \
  -d @messages.json
curl -X POST /api/v1/memory/flush
curl -X POST /api/v2/memory/search \
  -d '{"query":"...","method":"hybrid","top_k":3}'
EverOS 会先对 conversation 做 memory extraction。这批 10 条测试消息在本次运行中最终生成了 4 条 Episode、19 条 Atomic Fact 和 1 份 User Profile,并保存成 Markdown。随后 cascade 再读取这些 memory,为它们生成 embedding 和检索字段,写入对应的 Milvus Collection。
写入完成后,我们再用一个原始消息中有明确答案的问题测试 hybrid search:
工作日和周末的响应时限是什么?
返回结果命中了包含这条规则的 Episode,给出的内容是工作日 15 分钟、周末 30 分钟,同时结果中的 md_path可以继续定位回对应的episode-2026-09-09.md。
测试数据虽然不多,但说明从写入到检索的完整链路已经跑通。后续我们另外用 5 个能够从测试消息中直接核对答案的问题做了同样的搜索,都可以命中对应 memory 并回指 Markdown。
但是在检索过程中,我们也遇到了一个问题。
基于当前的EverOS 1.3.1 的日志命名规则。即使 backend 已经切到 Milvus,启动过程中仍可能看到 lifespan_provider_startup name=lancedb、cascade_lancedb_rebuilt 之类的历史名称。
因此确认实际 backend 时,不能只看这些日志字符串。我们最终通过 milvus_connection_opened、derived_index_ready backend=milvus,以及直接查询远程 Milvus 中的数据,确认索引确实已经写入 Milvus。
最后,虽然基于 EverOS 的这一套设计,我们并不需要对原始数据和记忆做完整迁移。但在实际迁移过程中需要注意:即使只做embedding数据重建,如果整体数据量较大,也需要预留一个重建窗口。
 尹珉
Zilliz 黄金写手