深度教程|毕昇如何用Milvus实现千人千权的企业级 RAG 检索
假设你问企业知识助手:我们去年与 A 公司签订的框架协议,赔偿上限是多少?
在一个 Demo 里,这只是一次向量检索;在一家真实的企业里,它首先是一次权限判断。
同一个知识空间里,可能同时存在公开制度、部门文档、项目材料、客户合同和管理层报告。一个人能进入空间,不代表他能看所有文件;能看某个文件夹,也不代表他能穿透被隐藏的子目录。权限还可能来自用户、部门、用户组、资源所有者、文件夹继承和针对单个文件的特例授权。
这就是企业级 RAG 和普通文档问答的分水岭:企业级RAG 不能先把答案找出来,再问用户有没有权限。权限必须成为检索本身的一部分。
以下内容,是北京数据项素 CTO姚劲,在开发企业场景的开源大模型应用开发平台BISHENG(毕昇)时,关于如何做企业级RAG权限管理的完整分享。
01
企业级RAG,不能把权限写到 Prompt
做权限管理,一个看似简单的做法,是先从向量库召回 TopK,再在 Prompt 里告诉模型:「请不要回答用户无权访问的内容。」
问题是,当这句话出现时,泄露就已经发生了。无权 chunk 已经被向量库返回,进入应用内存,甚至进入 LLM 上下文。即使模型最终没有在正文里输出,它仍可能从引用、文件名、摘要、日志或调试字段中泄露。
另一种做法是全量召回后过滤。它在安全上比 Prompt 约束更可靠,却会伤害召回率:假设 Top10 里的前 9 条都来自无权文件,过滤后只剩 1 条。系统虽然没有越权,但可能给出没有找到的错误答案。
针对以上问题,我们设计了一条前置过滤‑召回复核‑展示兜底的三层安全防链,全程保障用户无法访问越权的知识库内容。
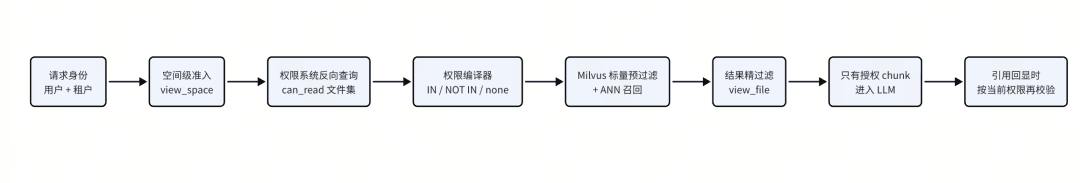
图 1:权限不是 RAG 外围的一次 API 校验,而是贯穿召回与引用的数据面。
第一步:检索请求会携带用户与租户身份发起查询,先完成知识库空间准入校验,再反向查询得到用户可读的文件集合
第二步:由权限编译器,将权限规则转化为 Milvus 可执行的 IN/NOT IN 标量过滤条件;
第三步:向量数据库会先基于该条件完成无权数据的前置过滤,再在合规数据集范围内执行 ANN 向量召回;
第四步:召回结果经过业务层文件权限的二次精筛后,会仅将授权范围内的文档切片送入大模型生成回答
第五步:最终在前端回填引用内容展示时执行最后一轮权限校验。
02
如何把人能看什么编译成向量库应该搜什么
企业权限系统和向量数据库擅长回答两类不同的问题:
权限系统擅长回答:「用户 1001 能读哪些 knowledge_file?」
Milvus 擅长回答:「在给定候选集内,哪些向量与问题最相似?」
两者之间需要一个权限编译层。
在毕昇的入库链路中,每个 chunk 都携带结构化元数据,其中 document_id 把向量世界里的 chunk 与业务世界里的文件连了起来:
chunk = {
     vector:        [...],
     document_id:   4821,
     knowledge_id:  73,
     chunk_index:  16,
     page:          8,
     ...
  }
检索时,系统先通过业务权限系统 PermissionService.list_accessible_ids() 获取当前用户可 can_read 的文件 ID,再与当前空间、文件夹、标签和主版本等业务范围求交集,最后生成 Milvus 可执行的布尔表达式:
expr = "document_id in [101, 205, 309]"
这一点与 Milvus 的 filtered search 模型正好契合:先用标量条件缩小候选集,再在匹配实体上执行 ANN 检索。它的价值不仅是更快,更是让无权数据尽量不进入向量相似度竞争。
03
为什么不能永远使用 IN
如果用户只能看 20 个文件,document_id in [...] 很理想。但如果一个空间有 10 万个文件,某位管理者可以看其中 99980 个,把这 99980 个 ID 全部塞进 IN 表达式,并不划算。
毕昇的 KnowledgeFileVisibilityService 会根据可见文件数 K、空间主版本文件总数 N 和默认阈值 5000,自适应选择策略:
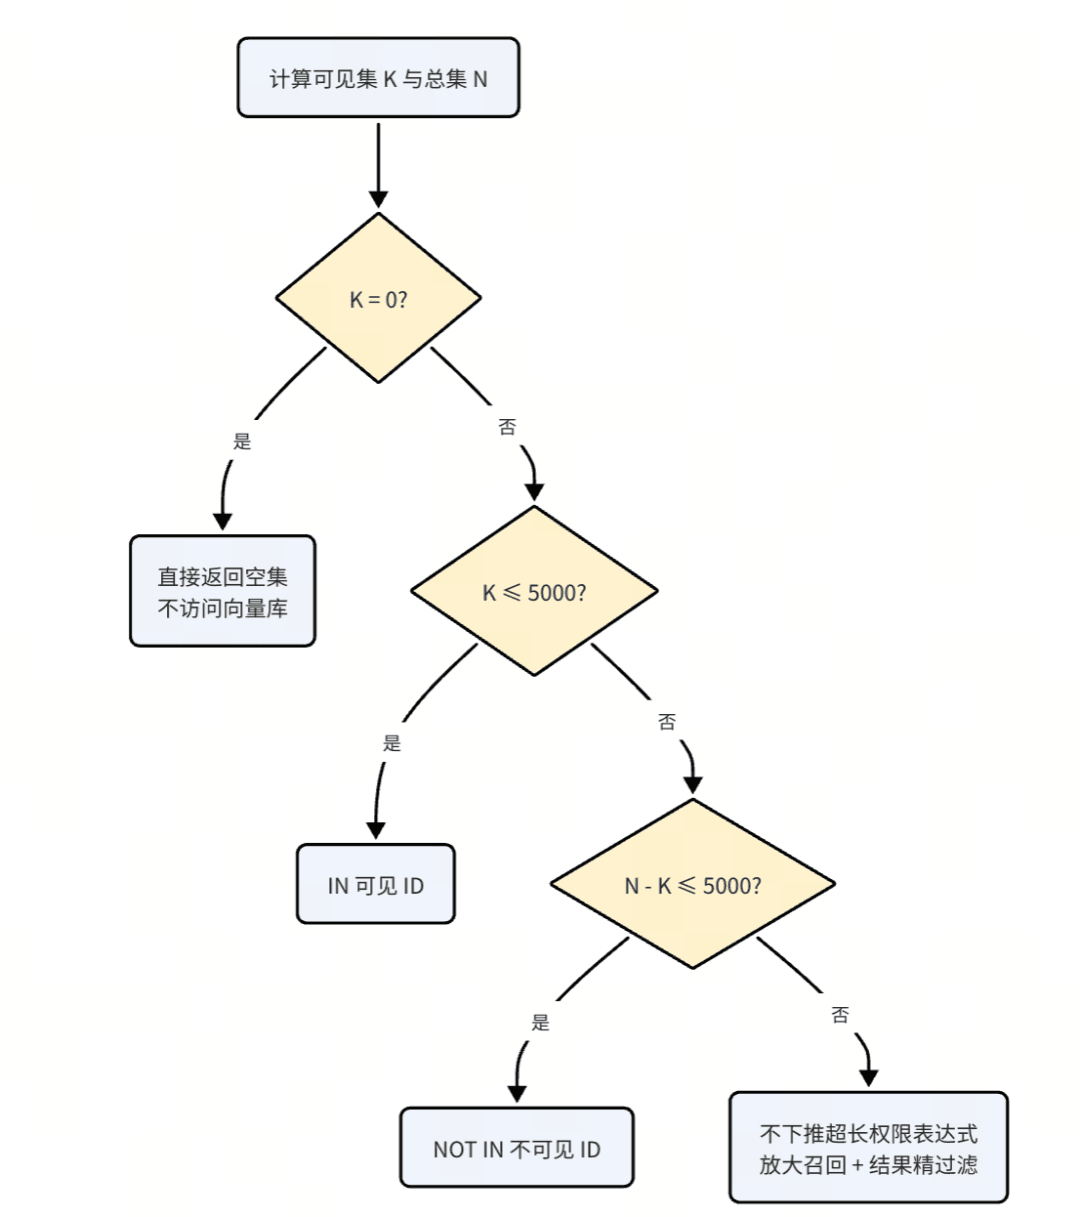
图 2:权限集的大小和密度,决定了它应该以白名单、黑名单还是后过滤形式进入检索。
这个决策有两个重要细节。
第一,文件夹和标签是业务边界,不是仅用于加速的权限边界。即使列表很大,也不能随意丢掉;当无法使用短 NOT IN 时,实现会优先保留 IN 条件,因为正确性高于表达式长度。
第二,主版本过滤与权限过滤是叠加的。用户有权访问某个文件,不代表该文件的旧版本仍应参与回答。
04
双层过滤:粗粒度为性能,细粒度为正确性
如果 Milvus 已经做了预过滤,为什么还要对召回结果再过滤一次?
因为企业权限不是一个简单的 can_read=true。
在毕昇的权限模型中,权限系统的 can_read 适合快速批量回答大致能读哪些文件;但列表 UI 里的最终可见性,还要经过 view_file 精细权限解析,综合文件到父文件夹、再到空间的关系链,以及「最近绑定优先」的特例规则。
因此,安全边界被分成两层:
索引层粗过滤:用 can_read 生成 Milvus expr,尽量缩小 ANN 的搜索空间。
结果层精过滤:只对召回结果中去重后的 document_id 解析 view_file,与前端文件列表使用同一套有效权限语义。
这里需要注意两次检查的职责不同:第一层决定去哪里找,第二层决定什么最终可以被看见。
05
权限过滤后 TopK 不够,怎么办?
在一个权限稀疏的空间里,一次召回的候选中可能有大量文件在精过滤阶段被删除。如果只召回用户需要的 TopK,答案很容易出现证据不足的问题;如果不断扩大召回直到凑齐,又可能制造无上限的延迟。
因此,当前代码采用有界扩张:
首轮按基准候选数的 3 倍召回;
如果精过滤后没有可用结果,最多再扩张一次到 6 倍;
总召回次数最多为 2,仍不足就返回现有结果,不做无限循环。
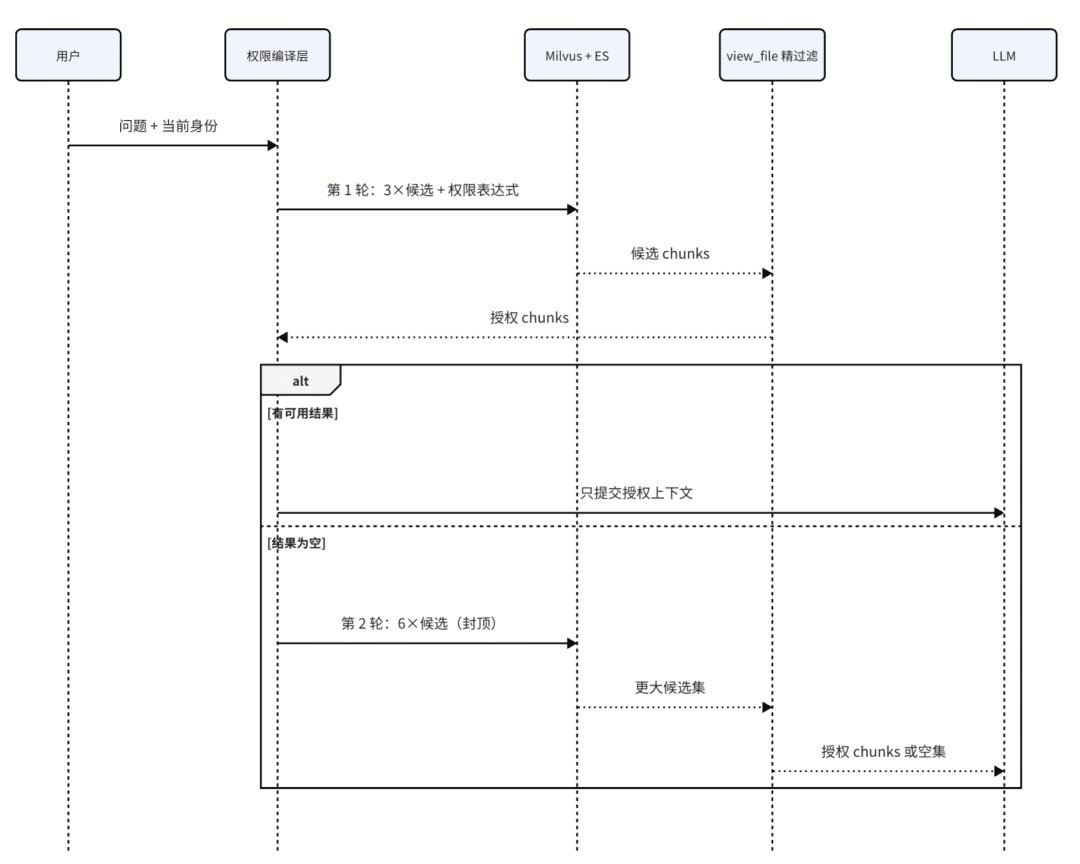
毕昇的 Milvus 适配层还会确保 HNSW 的 ef 覆盖实际 k,避免上层放大候选数时仍使用过小的搜索宽度。Milvus 官方将 ef 定义为 HNSW 搜索时评估的候选邻居数;它越大,通常召回越高,但延迟也会增加。
06
不要把每个人的 ACL 写进每个 chunk
当权限问题变复杂时,一个自然反应是:在每个 chunk 上写入 allowed_user_ids。
这对小规模系统可能有效,对企业系统却很快会变成权限数据复制灾难:一个部门的人员变更,可能需要改写数百万个 chunk;一次权限撤回,会变成长时间的索引更新窗口。
因此,实践中我们会选择:
权限系统维护「用户—部门—用户组—文件夹—文件」的关系与继承;
Milvus 维护稳定的业务键,例如 document_id 和 knowledge_id;
查询时把当前身份的有效权限编译成过滤条件。
这样,权限关系变化不会迫使向量全量重写。当前权限列表使用租户隔离的 Redis 缓存,默认 TTL 为 10 秒;授权变更走统一失效逻辑,正常情况下下一轮检索即可收敛,边缘情况由 TTL 兜底。
07
检索安全不等于答案安全
即使本轮检索是安全的,历史会话里的引用仍可能成为另一条越权通道。
例如,用户昨天有权限看合同 A,模型的回答中留下了 citation;今天管理员撤回权限后,用户再打开历史会话,如果 citation 解析接口仍返回文件名、摘要、下载链接或坐标信息,权限撤回就只做对了一半。
因此,毕昇的 citation resolve 链路会在回显时按当前权限重新校验:
有 view_file 的 RAG 引用正常返回;
已失去权限的引用整条剔除,不返回 placeholder,也不泄露文件名和 snippet;
单条无权引用以不存在语义处理,避免通过错误差异探测资源。
这条原则可以概括为:
检索时按当前权限取数,回显时仍按当前权限解析。历史答案不应成为权限快照。
08
企业级 RAG 还必须确定以谁的身份检索
在单人聊天场景中,这个问题很简单:用当前登录用户。但一旦进入工作流、助手和对外 RPC,身份语义会立即变复杂:
工作流应该使用流程创建者的权限,还是当前运行者的权限?
助手被共享后,召回应继承配置作者,还是每个调用者?
RPC 如果由系统 operator 发起,谁是真正的 on_behalf_of_user?
毕昇当前的流程/助手检索已显式选择权限身份:「用户知识库权限校验」开启时使用运行用户,关闭时使用配置作者,并将 access_scope 传递到后续引用链。
这比调一个权限 API更重要:如果身份本身没有定义清楚,任何权限判断都可能在精确执行错误的语义。
09
几个有意的失败策略
企业级检索最难的地方,往往不在正常路径,而在系统不完整时如何失败。
1. 权限系统暂时不可达
批量可访问 ID 查询失败时,检索链路不应为了可用性放行全量数据。当前语义是回退到可确定的 scope,否则视为空集,让该次问答少答而不是越权。
2. 用户有空间权限,但没有任何可见文件
这不是 403,而是合法的空检索。系统返回空文档集,由 Prompt 产生「未在你有权访问的内容中找到相关信息」之类的友好提示。
3. 多知识库检索中某个库失败
不让一个库的权限或向量存储故障污染整个批次。无空间权限的库静默跳过,单库初始化/检索失败按 KB 隔离,其他库仍可返回结果。
关于 BISHENG(毕昇)
BISHENG(毕昇)是一款面向企业场景的开源大模型应用开发平台(AgentOps),名字取自活字印刷术发明者毕昇 —— 正如活字印刷推动了知识的广泛传播,我们希望 BISHENG 能为智能应用的规模化落地提供有力支撑。
平台整合了 GenAI 工作流编排、RAG 知识库、智能 Agent、统一模型管理、效果评估、SFT 微调等核心能力,让企业能够以可视化、低代码的方式快速搭建知识问答、报告生成、要素提取、数据分析等各类 AI 应用,真正把大模型能力转化为业务生产力。
BISHENG 于 2023 年 8 月基于 Apache 2.0 协议正式开源,无任何附加协议,支持二次开发与商用。目前已被大量行业头部组织及世界 500 强企业采用,GitHub 累计收获超 1.1 万 Star。
 Jin Yao
CTO of DataElem