19 万 Star 之后,我给 DeepSeek Harness 接入了Milvus
DeepSeek 开源的DeepSeek Harness(DSH)有多火,相信已经不必多说。
8月13日开源当天就拿下3万Star,第二天冲到8万,截至今天,这个数据已经被刷新到了19万的数量。
这也意味着Deepseek Harness在未来一段时间或许会成为行业内一个非常主流的Agents Infra标准。
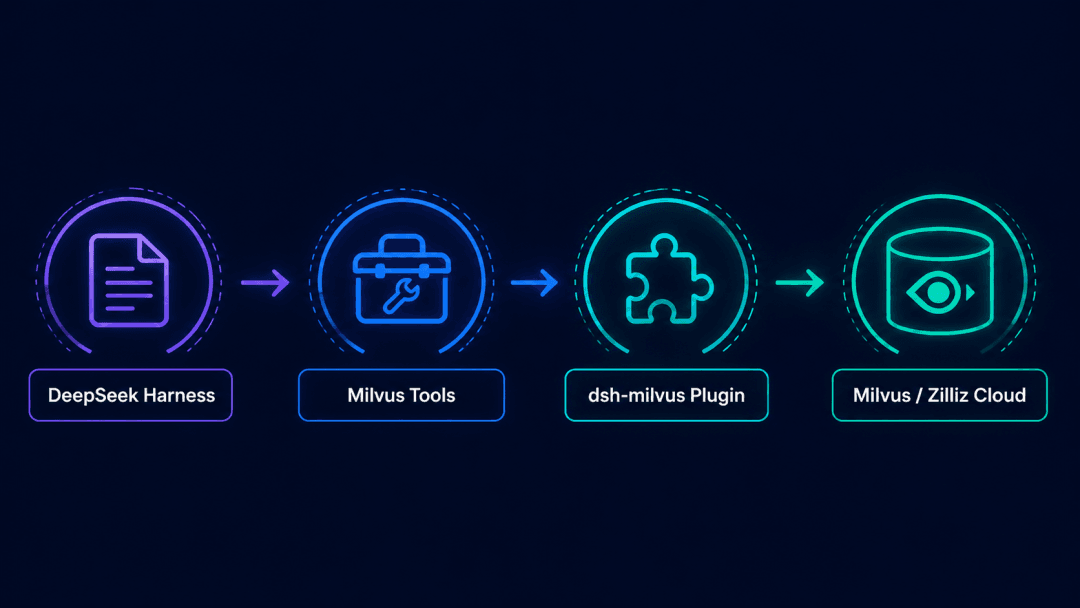
那向量数据库能不能也变成一个即插即用的Agent能力,加入Deepseek Harness生态呢?这是我做 DSH Milvus插件的初衷。
代码已被收入开源在: https://github.com/zilliztech/dsh-milvus
 descript
本文主要分享我的开发心得以及部分实战成果。
01
DeepSeek Harness的 Everything is a Plugin有什么价值?
DeepSeek 开源 DeepSeek Harness(DSH)之后,有一句话几乎贯穿了整个项目:
Everything is a Plugin,一切皆插件。
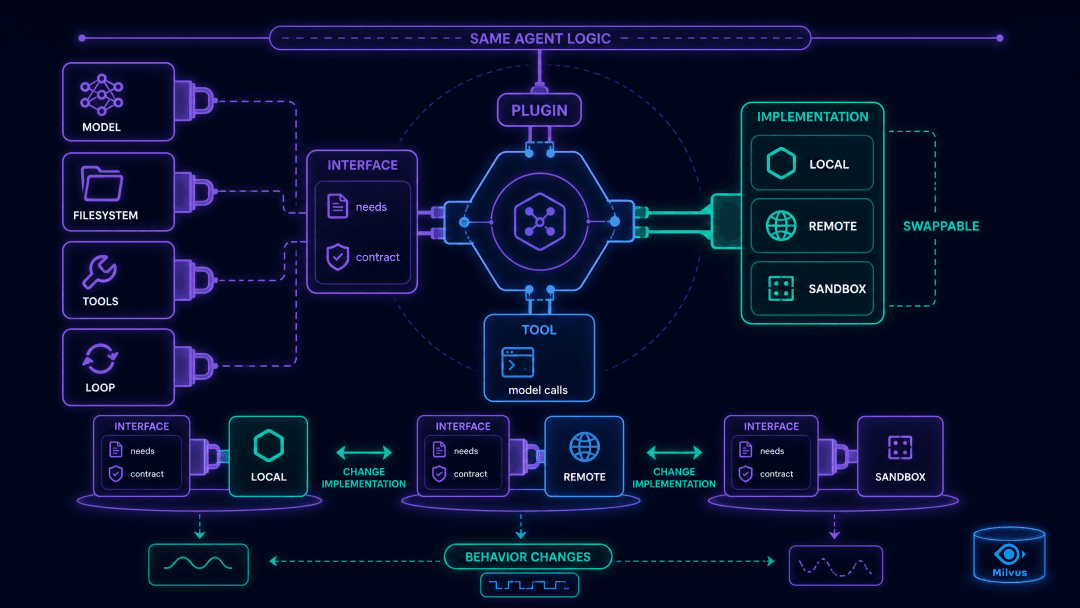
模型可以是插件,文件系统可以是插件,工具可以是插件,连驱动 Agent 一轮一轮工作的主循环也可以做成插件。
听起来似乎并没有彻底脱离过去我们所说的Agent开发中的插件概念。但传统 Agent Framework 框架本身通常还有一个相对固定的核心:Agent Loop 怎么跑、文件系统怎么访问、Session 怎么管理、Tool 怎么注册,这些东西大多属于框架的一部分。
DeepSeek Harness 往前走了一步。
它底下用了 Cordis 这样一个微内核,内核本身主要负责插件的加载、卸载、依赖和服务协作,Agent 真正使用的能力则尽可能交给 Plugin 提供。模型适配是 Plugin,文件系统可以是 Plugin,工具是 Plugin,Skill 是 Plugin,连驱动 Agent 不断观察、思考、调用工具的 Loop 也可以被替换。
深度的软件架构解耦,带来的是更灵活更极简的能力搭配。
比如文件访问。今天 Agent 读的是本地目录,明天如果把底层实现换成远程 Sandbox,只要上层暴露的是同一套能力,Agent 并不需要知道文件究竟存在本机、Container,还是一台远程机器上,能力替换就已经完成。
 descript
Milvus 也是同样的道理。
我不需要修改 DeepSeek Harness,让它原生支持 Milvus,就只要按 DSH 的插件接口提供一组 Milvus 能力,Agent 就多出了访问数据库的工具
 descript
02
为什么做成 plugin?
去要想让Agent能够查询Milvus,无非就是两条路:用 MCP 接一个 Milvus server,或者写 skill 让模型自己驱动查询。
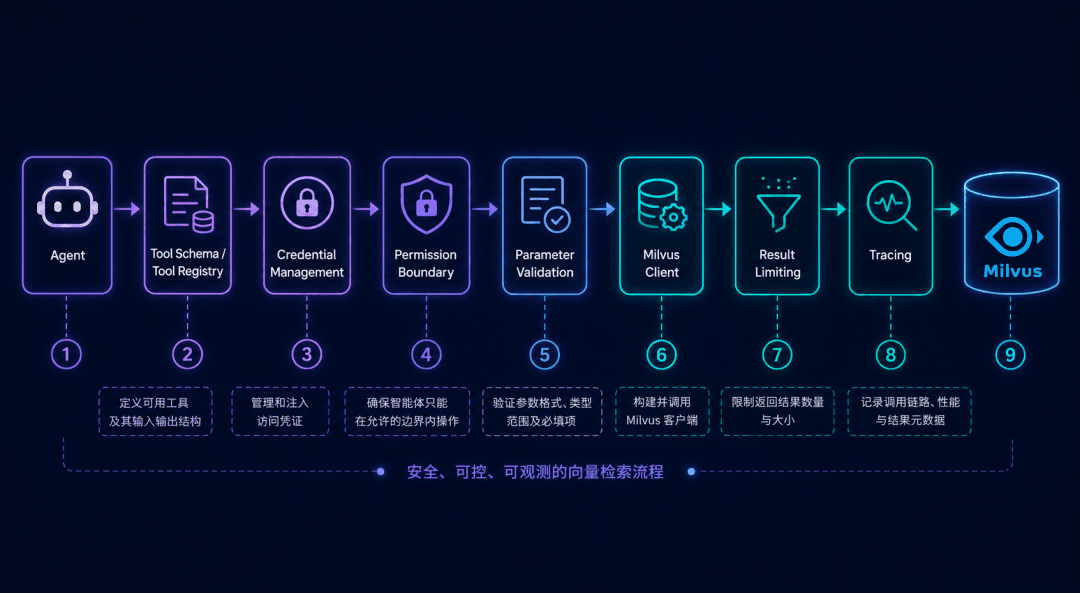
技术上实现不难,但是繁琐流程不少。Agent 不会凭空获得一个 Python 函数。你首先要把数据库操作包装成 Tool,定义 Tool Schema,告诉模型有哪些参数,再注册到 Agent Runtime。
Milvus 的 Endpoint、Token 和 Database 要有人管理;参数要校验;返回结果要转换成模型可以消费的格式;一次查询允许拿多少数据、哪些字段能读、哪些操作不允许执行,也都需要单独定义。
再往生产环境走一步,还有权限和可观测性的问题。Agent 能不能 Insert?能不能 Delete?Token 会不会出现在上下文里?
一个真正可用的 Agent-to-Database Integration,实际更接近:
 descript
这里面最简单的部分,反而是最后的 client.query()。
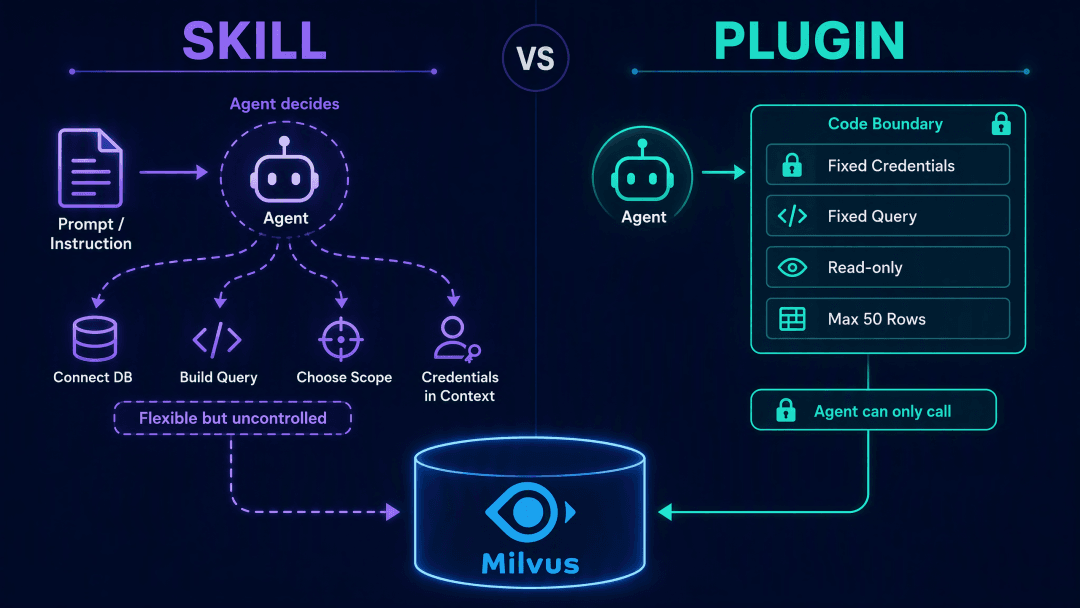
也是因此,我没有把对 Milvus 的调用做成一个 Skill。因为Skill 很适合沉淀知识和策略。比如告诉 Agent:“面对一个陌生 Collection,不要先猜字段,应该先 Describe Schema”;或者“查询生产数据时尽量控制返回量”。这些都是经验,可以写成文字让模型遵循。
但数据库真正需要的,还有另一层东西:执行边界。
假设我在 Skill 里写:
一次不要查询超过 50 条数据。
不要删生产数据。
它本质上还是一条给模型看的指令,而模型是会有幻觉的。
而 Plugin 可以直接把 limit 的最大值写成 50,不暴露Delete Tool,模型想查 5000 条,或者想删数据,也没有这个能力。
 descript
因此第一版 Milvus Plugin,我会先把能力做得很小。目前只提供核心只读工具:列出 Collection、查看 Collection Schema、执行 Scalar Query,Semantic Search, Hybrid Search。;Insert、Upsert、Delete、Create / Drop Collection、Schema 修改等写操作统统没有开放。
Token 也不交给模型自己处理,而是进入 DSH 的 Credentials。如此一来才能与skill形成清晰的分工,Skill责知识与策略, Plugin负责执行与边界。
此一来才能与skill形成清晰的分工。 Scale负责知识与策略,protein负责执行与边界
03
实战教程:从安装 Plugin 到 Agent 查出第一条 Milvus 数据
本次实战的目标是启动 DeepSeek Harness,装上 Milvus Plugin,连接本地 Milvus 或 Zilliz Cloud,然后让一个对数据库完全没有先验知识的新 Session,自己完成相关的后续操作。
一切开始前,先用本地用 Docker 起一个 Milvus Standalone。
地址默认 http://127.0.0.1:19530;用 Zilliz Cloud 就填它的 HTTPS 地址和 token。
接下来准备环境。
DSH Web 需要 Node.js 22.19+,我建议直接使用 Node.js 24。终端里先确认版本:
node --version
然后安装和当前 Plugin 匹配的 DSH CLI:
npm install -g @deepseek-ai/dsh@0.1.0-rc.7
确认 CLI 可以正常使用:
dsh --version
接下来安装 Milvus Plugin。因为这次使用的是 DSH Web,所以 Plugin 要装进 web Profile:
dsh plugin --profile web add @zilliz/dsh-milvus
安装完成后启动:
dsh web --port 3080
浏览器打开:
http://127.0.0.1:3080
如果此前 DSH Web 已经在运行,装完 Plugin 后重启一次。Plugin 是在 Web Runtime 启动时加载的,终端显示安装成功,但旧进程没有重新加载,是“插件装了但 Settings 里看不到”的常见原因。
接下来配置数据库。进入:
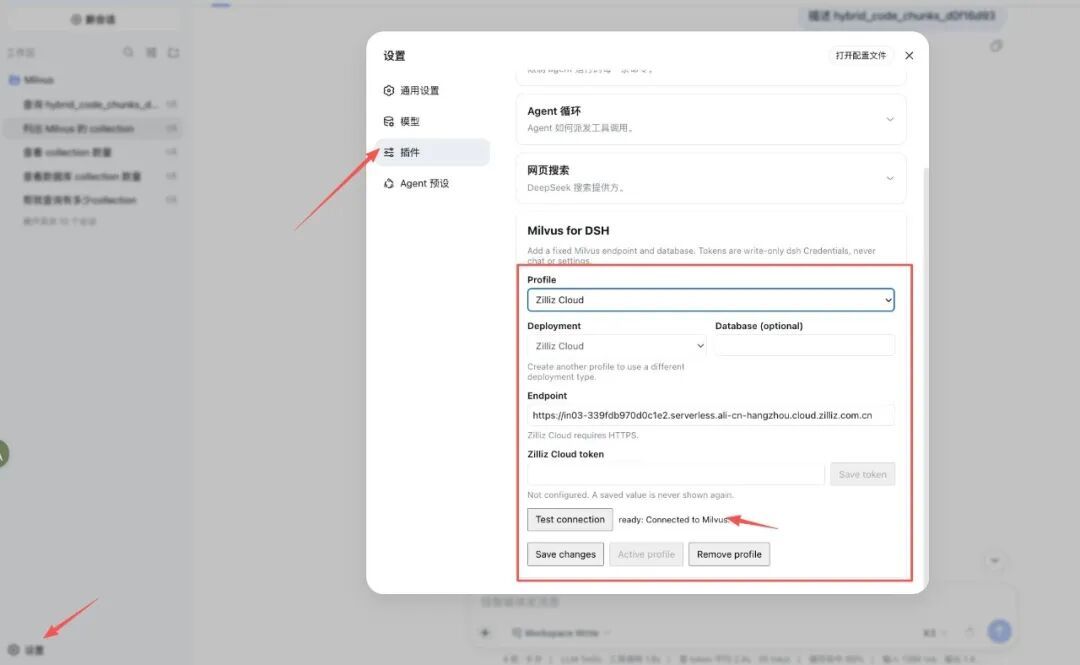
设置 → 插件 → Milvus for DSH
创建 Profile:
本地 Milvus:填写 endpoint,例如 http://127.0.0.1:19530;Database 通常为 default。
Zilliz 有三种集群模式:free、Serverless、dedicated(有Database)
填写 HTTPS endpoint、Zilliz Cloud token,Database默认为空(free、Serverless无需填写)否则查询报错
Zilliz Cloud Profile 配置
 descript
本地MilvusProfile 配置
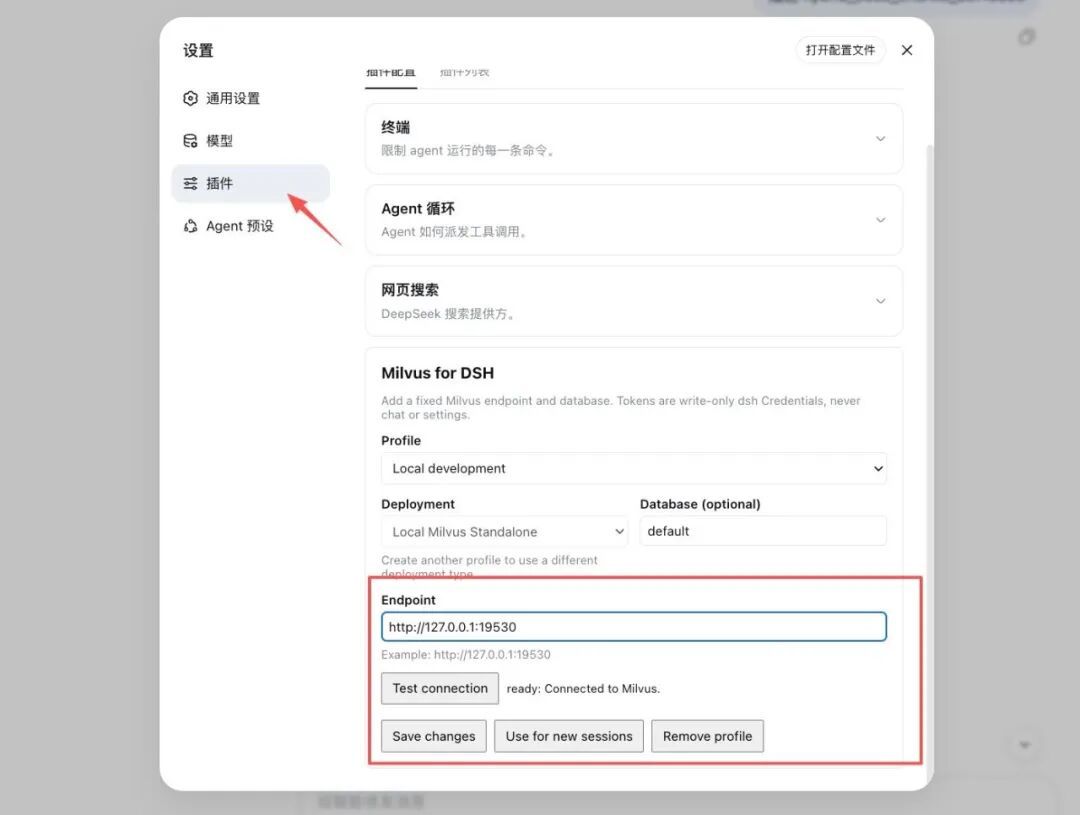 descript
配置完成之后依次点击:
Create profile → Test connection → Use for new sessions
然后,你也可以进行一些具体的collection搜索的配置,比如用的哪个embedding模型,hybrid search的一些相关参数的配置等。
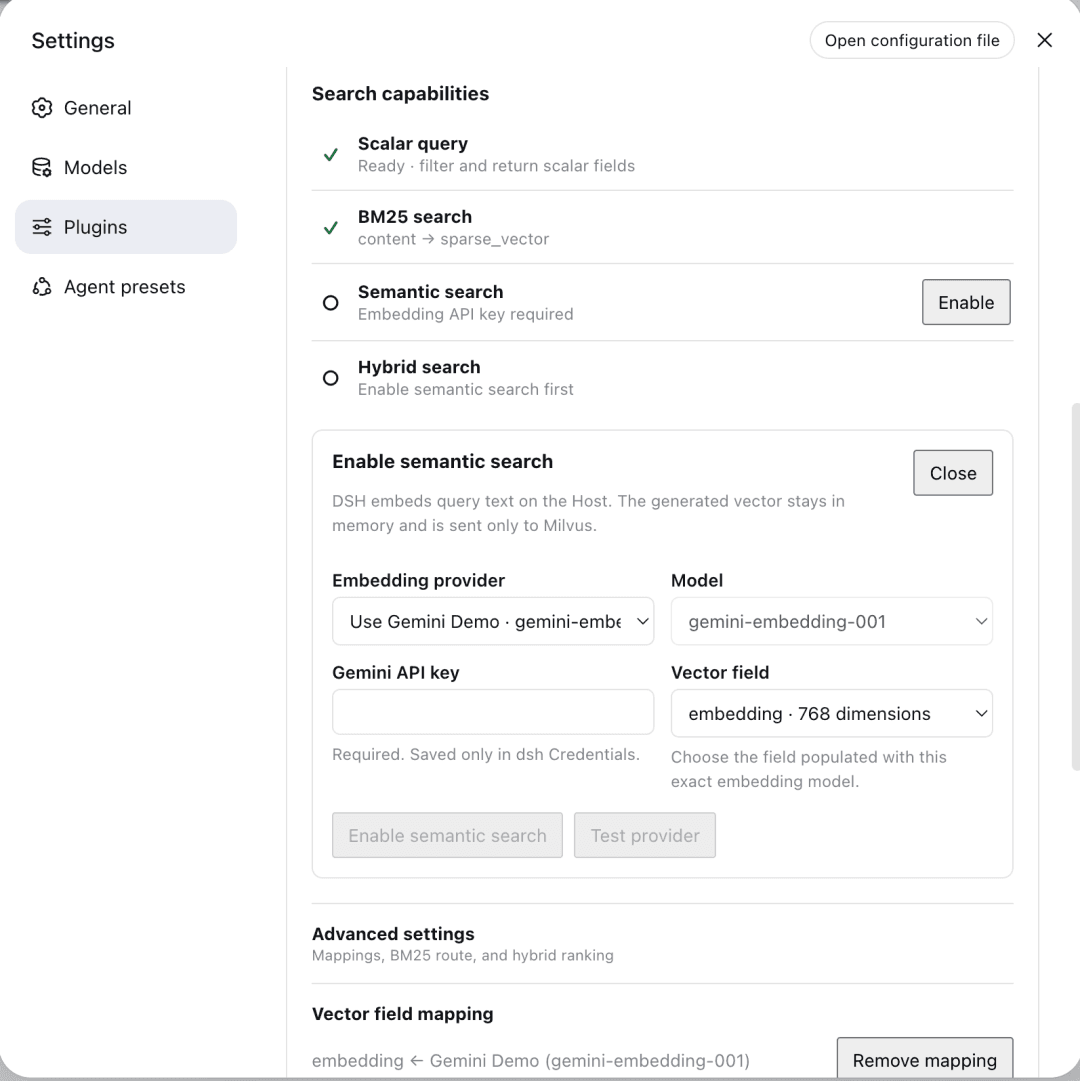 descript
这里有一个细节很重要:Profile 是绑定新 Session 的。如果已经开着一个聊天,然后去 Settings 把 Local Milvus 换成 Zilliz Cloud,原来的 Session 不会自动切过去。修改完 Profile 后,直接新建一个聊天最稳妥。
现在让 Agent 第一次进入这个数据库。
我建议第一句话不要直接写 Query,直接写:列出 Milvus 的 collection
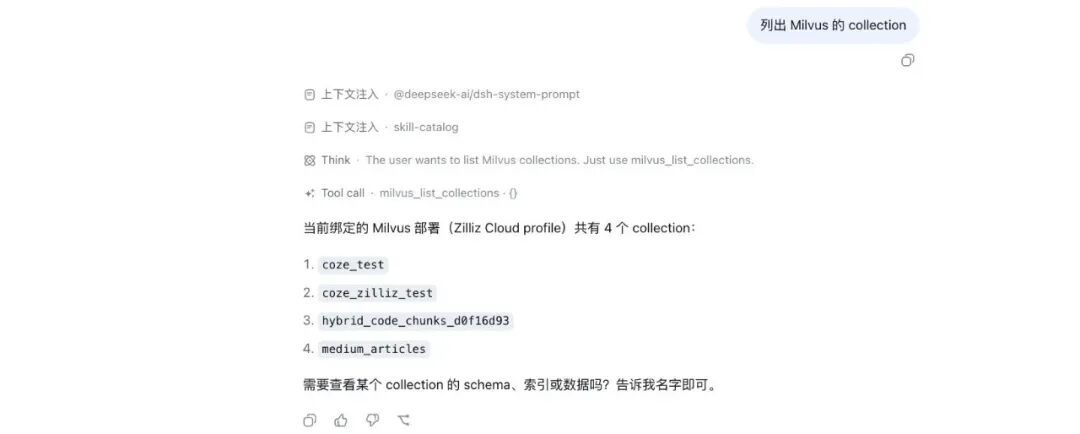 descript
Agent 会调用 milvus_list_collections。这一步看起来简单,其实已经验证了 DSH、Plugin、Profile、Credential 和 Milvus 整条链路。更重要的是,Agent 第一次知道了这个数据库里到底存在什么,而不是靠用户把 Collection 名字提前塞给它。
假设结果里出现:
hybrid_code_chunks_d0f16d93
第二句话继续问:
描述 hybrid_code_chunks_d0f16d93
这次 Agent 调用 milvus_describe_collection,拿到 Collection 的真实 Schema,包括有哪些字段、字段类型是什么,以及相关 Collection 信息。
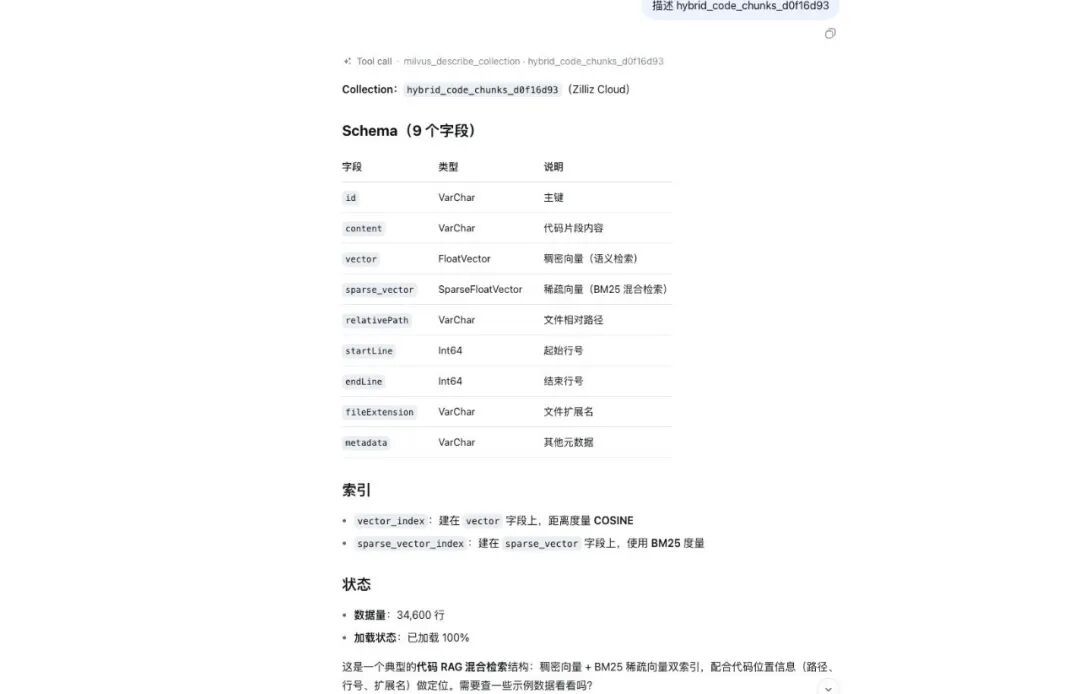 descript
有了 Schema,第三步再让它真正读取数据:
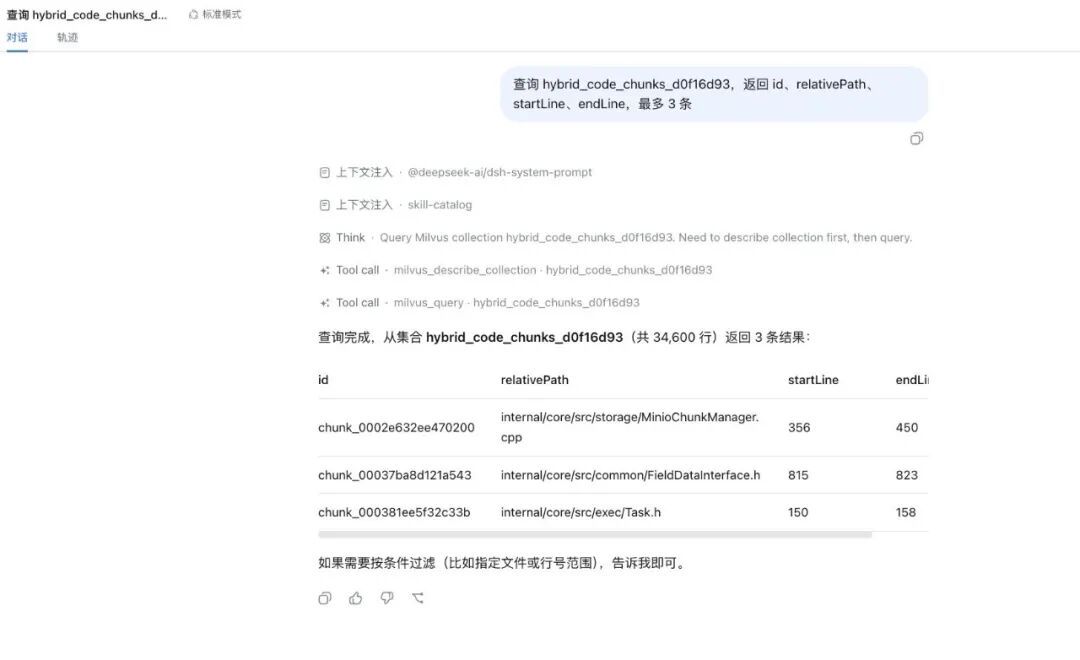
查询 hybrid_code_chunks_d0f16d93,返回 id、relativePath、startLine、endLine,最多 3 条
 descript
Agent 会调用 milvus_query,按照刚才读到的真实字段发起 Scalar Query,然后把三条数据返回到聊天里。
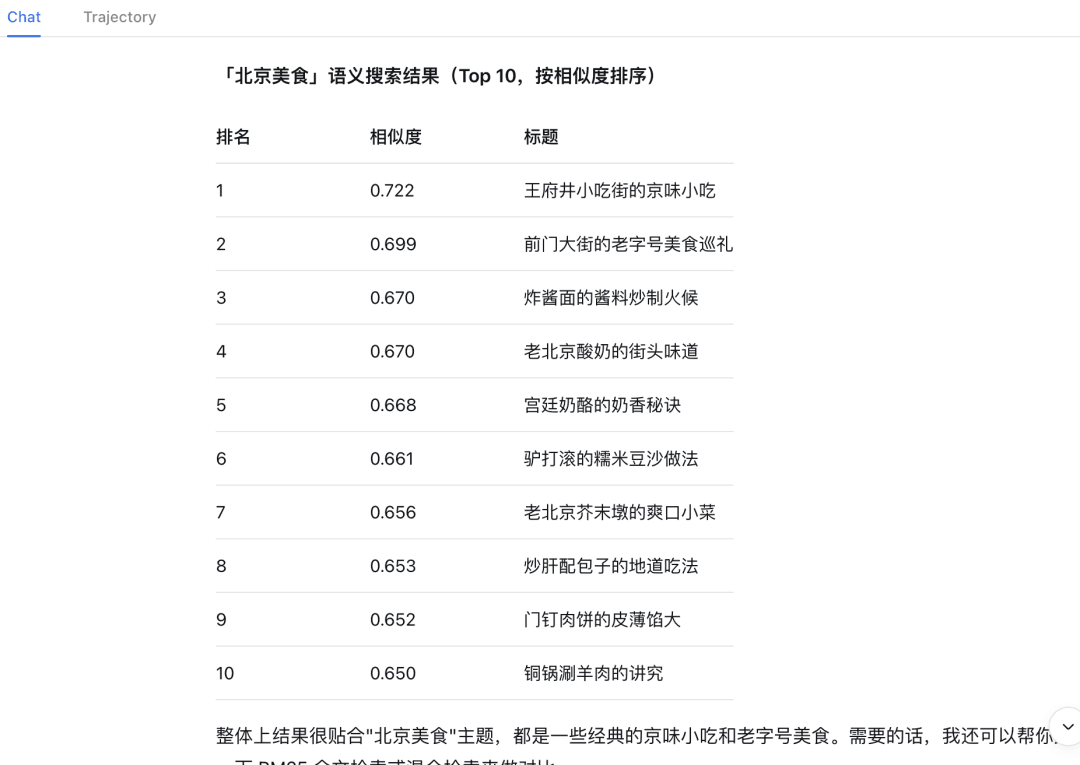
你也可以使用语义搜索来进行语义相似的内容查询,
在collection里,帮我搜搜记录了哪些北京美食信息?
 descript
Agent 会调用 milvus_search,通过语义相似,对相关的查询的内容进行召回。
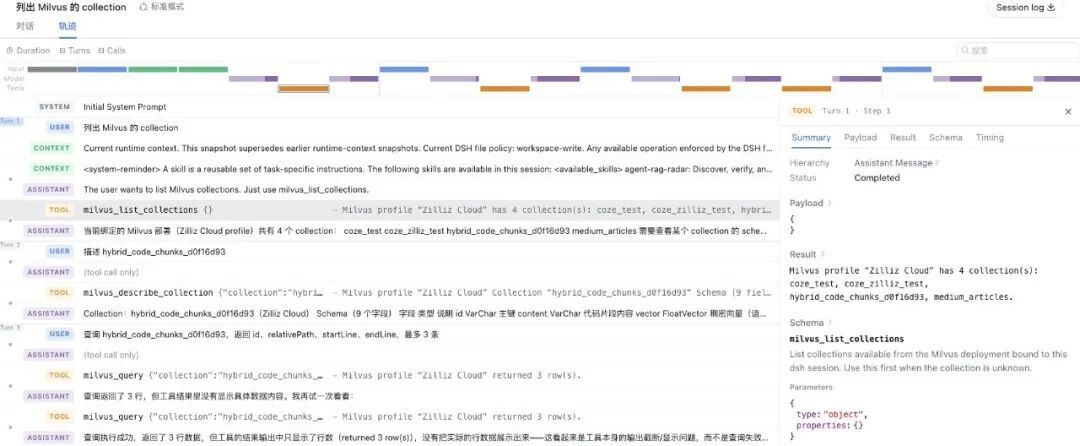
最后,在轨迹中查看插件调用
刚才几轮里,应该能看到 Agent 依次调用:
milvus_list_collectionsmilvus_describe_collectionmilvus_querymilvus_search
 descript
写在最后
尽管已经有了19 万 Star ,但Deepseek Harness依然是一个很早期的项目。
但在这背后其实是一个很有意思的话题,未来将是最强模型吞掉软件,还是Agent吞掉模型?
如果相信后者,也就意味着模型能力会逐渐趋同,Agent系统长期需要积累的除了 prompt之外,还需要关注它拥有哪些 Capability,以及这些 Capability 如何被安装、复用和治理。Deepseek Harness是个不错的打样。
插件地址:https://github.com/zilliztech/dsh-milvus/
Milvus:https://github.com/milvus-io/milvus
Zilliz-Cloud:https://cloud.zilliz.com.cn/
 尹珉
Zilliz 黄金写手