全球顶级音乐平台,如何用Milvus对超1亿首歌曲做听歌识曲?
走在街上听到一段喜欢的旋律,或是脑子里盘旋着半句记不清名字的歌,是很多人都有过的经历。
对用户来说,找歌的线索往往是几秒录音、几句模糊歌词;但对坐拥亿级曲库的全球音乐平台而言,要顺着这些零碎信息精准定位作品,远不是 “搜一下” 这么简单。
今天案例的主角,就是一家面临这样需求的全球音乐流媒体平台。目前,这个平台已收录超过 1 亿首歌曲,服务覆盖 100 多个国家和地区,拥有数亿听众。为此,他们用一套统一的向量检索体系,把歌曲识别、模糊歌词搜索、音乐推荐甚至版权风控全都串了起来,而支撑这套体系的底层引擎,正是 Milvus。
以下是这家巨头的实践经验分享。
01 曲库越丰富,找到一首歌就越难
很多人都知道,音频识别、模糊搜索可以靠向量相似度来做。但原理归原理,真放到 1 亿首歌的体量里落地,要面临的是包括召回率、QPS、延迟在内的一串连锁问题。
传统的关键词搜索,在面对哼唱、录音这类非文字输入时本来就彻底失效。换成向量检索的思路,平台首先要面对的就是数据量的指数级膨胀。用户随手录下的几秒声音,可能来自歌曲的任意段落,为了保证匹配精度,每首歌都要被切分成大量相互重叠的短片段,每个片段单独生成特征向量。
1 亿首歌拆解下来,就是数十亿条音频向量,再加上歌词向量、各类元数据,检索基数瞬间翻了几十倍。
更棘手的是实时性压力。 用户想找的可能是刚上线的热门新歌,也可能是几乎无人问津的冷门作品,这意味着全量曲目都必须保持随时可检索的状态。平台要在数十亿向量的规模下,承接每秒数百次的查询请求,还要源源不断地入库新歌。既要保证新上传的作品能立刻被检索到,又不能因为持续的数据写入、索引构建,拖慢线上搜索的响应速度。
这些问题凑到一起,平台亟需一套既能扛住海量数据、又能稳定输出低延迟,还能兼容多种检索场景的底层向量检索引擎。
02 从声音到文字,Milvus如何覆盖全场景找歌需求
平台的解法,是围绕音频与歌词两套核心数据,搭起一层统一的检索能力,再通过元数据把检索结果和业务规则打通,最终覆盖从找歌到推荐、风控的全链路。
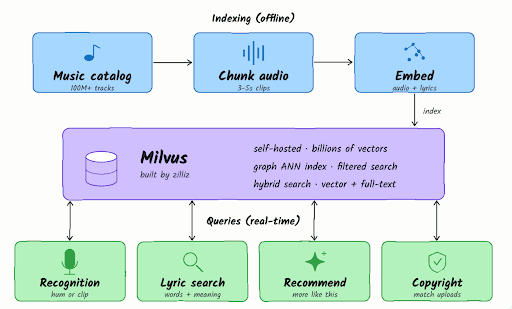
针对最常见的 “录音识曲” 场景,核心是解决 “片段匹配整首” 的问题。平台把每首歌切分为按时间排列的重叠短片段,通过音频模型提取旋律、节奏、音色等特征,生成对应的向量序列。用户发起识别时,录音会经过同一个模型转为向量,先在库中检索出相似的片段,再根据片段的先后时序做二次校验 —— 当多个连续片段都指向同一首歌时,识别结果的可信度就会大幅提升。
解决了声音的问题,再看歌词检索的场景。用户找歌时的歌词输入往往分成两种:一种是记得准确的原句,另一种是只记得大概意思,甚至因为 “空耳” 记错了用词。如果只做关键词匹配,后者就很难命中;如果只做语义检索,精准输入的效率又会打折扣。平台的方案是在检索层同时保留歌词语义向量与 BM25 全文索引,一次查询同时计算字词匹配度与语义相似度,输出统一排序的结果。 对用户来说,不管是准确输入还是模糊描述,都能在同一个搜索框里得到结果;对研发团队来说,也不用为两种检索模式分别维护两套独立系统。
光 “找到歌” 还只是第一步,真正要落地到业务里,还要叠加大量规则约束。比如推荐的歌曲在用户所在地区有没有播放版权、上传的音频片段归属哪一家版权方、 相似推荐要不要优先匹配同流派同艺人的作品……平台把艺人、专辑、曲风、发行时间、热度、地区、版权信息等元数据,和向量数据关联存储,在检索阶段就通过标量过滤完成条件筛选。
在此基础上,这套检索能力很自然地延伸到了更多业务里:以用户正在播放的歌曲为基准,叠加地域、偏好等条件,就能输出风格相近的推荐歌单;把用户上传的音频、视频片段切片后和全曲库比对,哪怕原作被加速、变调、翻唱,也能通过特征相似度识别出来,帮平台规避版权风险。
03 支撑十亿级向量的底层底座,为什么选 Milvus
针对以上需求与场景,平台最终选择 Milvus 作为统一检索引擎,本质上是看中了它三个层面的适配性。
首先是规模上的弹性。 作为分布式向量数据库,Milvus 天然支持百亿乃至千亿级的向量规模,不用随着曲库扩张推倒重构底层架构。平台目前已经沉淀了十亿级的音频片段向量,后续曲库再翻几倍,也只需要横向扩容集群就能承接,架构本身不用做大的调整。
其次是性能上的稳定性。 平台目前用 HNSW 索引承载语义检索,能在每秒数百次并发的情况下,把检索延迟控制在 10 毫秒左右, 完全满足实时识曲的要求。更关键的是,Milvus 把索引构建和在线查询做了隔离,新歌持续入库、构建索引的过程,不会明显影响线上搜索的响应速度。 针对不同业务的性能侧重 —— 比如歌曲识别更看重低延迟,全库版权匹配更看重吞吐量与召回率 —— 团队还可以部署多套独立集群,按需分配资源、调整配置,互不干扰。
最后是研发效率上的优势。Milvus 同时支持向量检索、全文检索与标量过滤, 让平台可以在同一套查询链路里兼容音频识别、歌词搜索、带条件筛选的推荐与风控等多种场景,不用为不同业务重复搭建检索底座。团队可以把更多精力放在匹配策略优化、产品体验打磨上,而不是反复造轮子。
 Zilliz