



Milvus 3.0 Embedding模型升级教程:从向量回填到灰度切流
在RAG、多模态搜索、推荐系统等AI 应用中,项目运行时,要更换Embedding 模型是个司空见惯的常事。
但模型升级并不只是更换查询端的配置:历史文档都要重新生成向量,用户的查询还在继续,新文档也可能不断写入。即便升级成功,新版本也可能出现不符合预期的延迟或检索结果,系统需要为新模型的效果验证和回滚留出空间。
那么在系统中,我们应该如何平稳升级Embedding 模型,又该如何判断最终的升级效果?
不妨使用Milvus 3.0 最新推出的在线新增和删除向量字段能力。系统可以在旧模型继续服务的同时,完成新向量回填和效果验证,并允许新字段暂时为空。确定效果后,再逐步切换流量,最后删除旧字段,完成 Embedding 模型的平滑迁移。
接下来,本文以知识库系统为例,在Milvus 3.0 中,将 Embedding 模型从 BGE-small-en-v1.5 切换至 BGE-base-en-v1.5。
实验基于 Milvus 3.0.2、PyMilvus 3.0.2 和公开数据集 SciFact,后续按照图 1 的六个阶段展开。
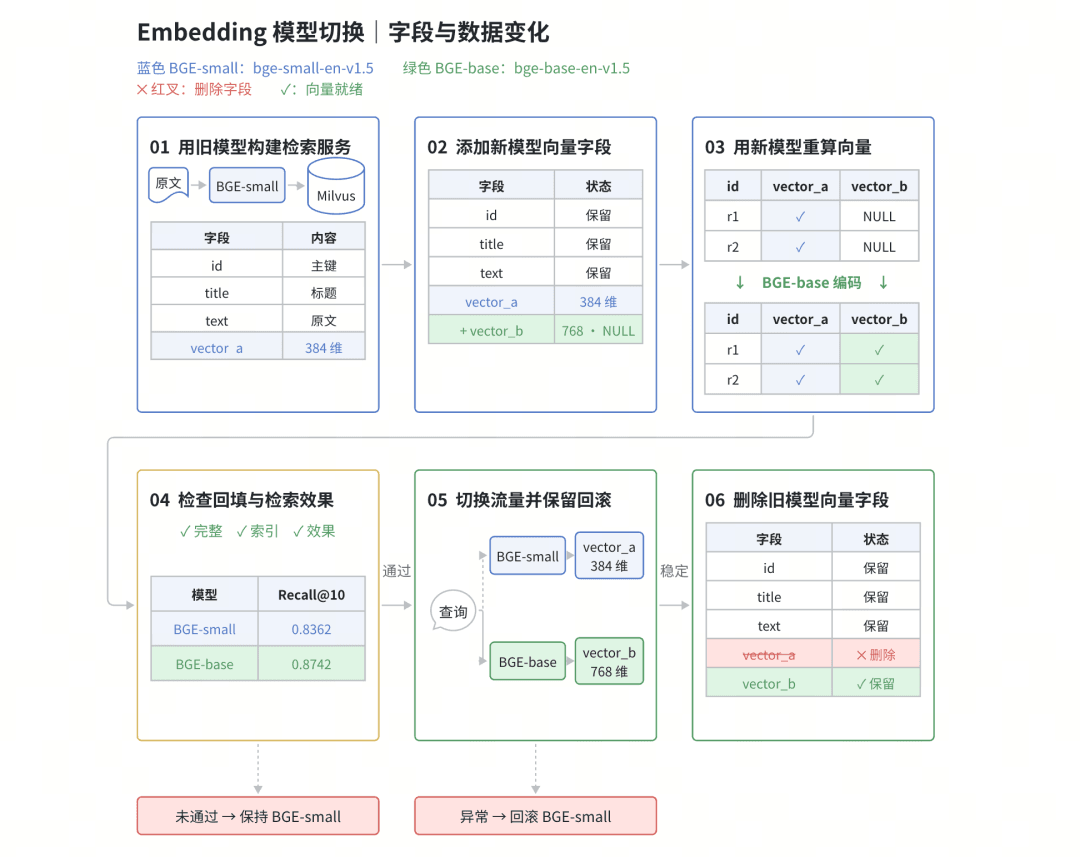 图 1|Embedding 模型迁移的六个阶段
Step 1:用旧模型构建检索服务
实验采用 BEIR 中的SciFact 数据集,包含 5,183 篇科学文献,以及 300 条测试查询和对应的相关性标注,用于构建文献知识库并比较迁移前后的检索效果。
旧模型为 BGE-small-en-v1.5,候选模型为 BGE-base-en-v1.5。两个模型的维度不同,适合用来验证跨维度迁移;模型规格见BAAI 模型卡。
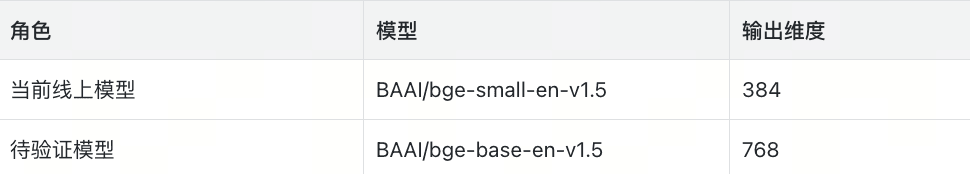 表 1|迁移前后的 Embedding 模型与向量维度
为控制实验变量,我们需要控制文献主键、分块和文本处理方式:每篇文献的标题与摘要拼接为一个文本片段,对应一条实体记录(Entity)。迁移期间保持分块方式和主键不变。两个模型的最大输入长度均为 512 tokens,超出部分由分词器截断;本文指标均基于这一文本处理方式。
本例通过 Milvus 模型集成库 pymilvus.model(0.3.4)调用 Sentence Transformers,在 CPU 上以 FP32 运行上述两个 BGE 模型。
准备可连接的 Milvus 3.0.2 实例,从GitHub 仓库获取代码后,以下以 Linux x86_64、Python 3.12 和 CPU 推理为例,执行这些命令即可运行完整实验。后续代码片段用于解释各阶段的实现,无需在运行脚本后重复执行。连接其他实例时,替换 --uri 参数:
uv venv --python 3.12 .venv
uv pip install --python .venv/bin/python "torch==2.14.1+cpu" \
  --index-url https://download.pytorch.org/whl/cpu
uv pip install --python .venv/bin/python -r requirements.lock.txt
HF_HUB_DISABLE_XET=1 .venv/bin/python run_public.py \
  --uri http://localhost:19530 --model-cache ./models
脚本会自动下载数据,并在独立的测试 Collection 中完成整个迁移流程。部署新实例可使用仓库中的 Docker Compose 配置。
首先初始化 Milvus 客户端,并通过 SentenceTransformerEmbeddingFunction 加载两个 BGE 模型。代码中,model_a、vector_a 和路由值 "A" 对应 BGE-small-en-v1.5;model_b、vector_b 和路由值 "B" 对应 BGE-base-en-v1.5。后续示例共用此处的 client 与 Collection 名称 name:
import torch
from pymilvus import DataType, MilvusClient
from pymilvus.model.dense import SentenceTransformerEmbeddingFunction
from run_public import MODEL_REVISIONS
torch.set_num_threads(2)
client = MilvusClient(uri="http://localhost:19530")
name = "scifact_model_upgrade"
prefix = "Represent this sentence for searching relevant passages: "
options = dict(
    device="cpu",
    batch_size=8,
    normalize_embeddings=True,
    query_instruction=prefix,
    doc_instruction="",
    cache_folder="./models",
)
model_a = SentenceTransformerEmbeddingFunction(
    model_name="BAAI/bge-small-en-v1.5",
    revision=MODEL_REVISIONS["A"],
    **options,
)
model_b = SentenceTransformerEmbeddingFunction(
    model_name="BAAI/bge-base-en-v1.5",
    revision=MODEL_REVISIONS["B"],
    **options,
)
model_a.model.max_seq_length = 512
model_b.model.max_seq_length = 512
初始集合结构(Schema)包含文献主键、标题、原始文本,以及 BGE-small-en-v1.5 对应的向量字段 vector_a:
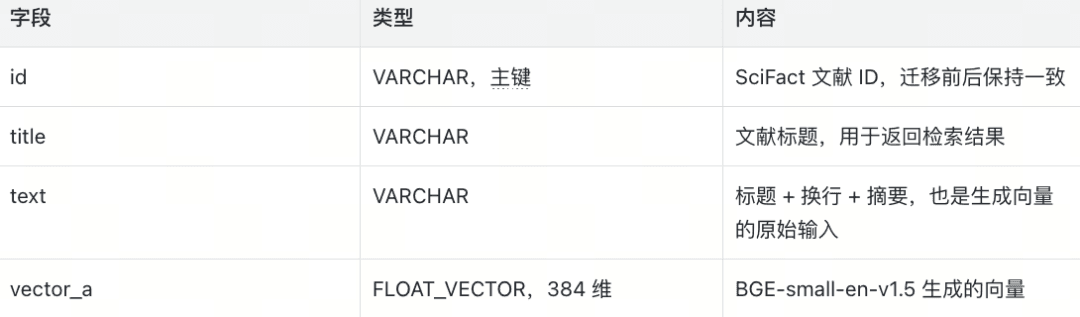 表 2|初始 Collection 的字段定义
schema = client.create_schema(auto_id=False, enable_dynamic_field=False)
schema.add_field("id", DataType.VARCHAR, max_length=64, is_primary=True)
schema.add_field("title", DataType.VARCHAR, max_length=2048)
schema.add_field("text", DataType.VARCHAR, max_length=65535)
schema.add_field("vector_a", DataType.FLOAT_VECTOR, dim=384)
client.create_collection(name, schema=schema, consistency_level="Strong")
load_data() 从 BEIR 官方下载地址加载完整语料。将文献的 _id、title、text 转换为实体记录后,使用 BGE-small-en-v1.5 生成向量,并分批写入 Milvus:
from run_public import load_data
docs, queries, qrels = load_data()
rows = [
    {"id": d["_id"], "title": d["title"],
        "text": d["title"] + "\n" + d["text"], }
    for d in docs
]
for start in range(0, len(rows), 32):
    batch = rows[start:start + 32]
    vectors = model_a.encode_documents([r["text"] for r in batch])
    client.insert(name, data=[
            {**r, "vector_a": v.tolist()} for r, v in zip(batch, vectors)
        ])
向量写入后,为 vector_a 创建 HNSW 索引并加载 Collection。索引创建函数也用于后续的 vector_b 字段:
def create_vector_index(field):
    params = client.prepare_index_params()
    params.add_index(
        field_name=field,
        index_name=field + "_hnsw",
        index_type="HNSW",
        metric_type="COSINE",
        params={"M": 16, "efConstruction": 100},
    )
    client.create_index(name, index_params=params)
client.flush(name)
create_vector_index("vector_a")
client.load_collection(name)
此时,旧模型已可以提供检索服务;新向量准备期间,查询继续使用这套配置。
Step 2:为新模型添加向量字段
BGE-small-en-v1.5 输出 384 维向量,BGE-base-en-v1.5 输出 768 维向量,因此需要为新模型增加独立的向量字段和索引。两个字段分别定义维度和索引,检索时通过 anns_field 指定目标字段。
将不同维度的新向量写入原字段会触发维度校验错误。即使维度相同,不同模型生成的向量通常也不具备直接比较的语义基础,因此不应在同一检索空间中混用。
本例保留 vector_a,新增 vector_b 并创建索引:
client.add_collection_field(
    name, field_name="vector_b",
    data_type=DataType.FLOAT_VECTOR, dim=768, nullable=True,
)
create_vector_index("vector_b")
新增字段必须设置 nullable=True,以表示历史记录尚未生成的新向量。字段创建操作本身不触发 Embedding 推理,新向量需要由应用计算并写入。此阶段的查询仍由 BGE-small-en-v1.5 和 vector_a 处理。
Step 3:用新模型重新生成文档向量
从 Milvus 的 text 字段分批读取原文,使用 BGE-base-en-v1.5 重新生成向量,再按主键写入 vector_b。设置 partial_update=True,保留未提交的标题、正文和旧向量。若原文存储在其他系统中,则按主键读取并关联:
iterator = client.query_iterator(
    name,
    filter="",
    output_fields=["id", "text"],
    batch_size=32,
    consistency_level="Strong",
)
first_batch = True
try:
    while True:
        batch = iterator.next()
        if not batch:
            break
        vectors = model_b.encode_documents([r["text"] for r in batch])
        client.upsert(
            name,
            data=[
                {"id": r["id"], "vector_b": v.tolist()}
                for r, v in zip(batch, vectors)
            ],
            partial_update=True,
        )
        if first_batch:
            client.flush(name)
            client.load_collection(
                name,
                load_fields=["id", "title", "text", "vector_a", "vector_b"],
            )
            client.refresh_load(name)
            first_batch = False
finally:
    iterator.close()
Step 4:检查回填结果,对比检索效果
切换流量前,应确认历史回填与增量同步已完成、新索引已构建、目标字段已加载,并通过实际检索验证可用性。完整脚本还会逐条核对原文与向量;任何检查未通过,都继续使用旧模型。
import time
client.flush(name)
client.refresh_load(name)
deadline = time.monotonic() + 180
while True:
    state = client.describe_index(name, "vector_b_hnsw")
    if (
        state.get("state") == "Finished"
        and state.get("pending_index_rows", 0) == 0
    ):
        break
    if time.monotonic() > deadline:
        raise TimeoutError(str(state))
    time.sleep(1)
首批回填后的检索检查表明,已回填的记录可以被召回,向量值为 NULL 的记录不参与该字段的检索。
检查通过后,在相同语料和查询集上比较两个模型的检索效果。
本实验使用 SciFact 的全部 300 条测试查询,比较 Recall@10 和 nDCG@10。Recall@10 衡量前 10 条结果对相关文献的覆盖比例;nDCG@10 进一步考虑相关文献的排序位置。两个指标均对测试查询取平均。
评测时,每个模型分别编码查询文本,并检索由自身生成的文档向量。encode_queries() 会自动添加初始化时配置的查询指令,因此直接传入查询原文,避免重复拼接前缀。以下代码通过 BGE-base-en-v1.5 编码查询,再检索 vector_b:
query_ids = sorted(qrels, key=int)
query_vectors_b = model_b.encode_queries([
    queries[qid] for qid in query_ids
])
results_b = client.search(
    name,
    anns_field="vector_b",
    data=[v.tolist() for v in query_vectors_b],
    limit=10,
    search_params={"metric_type": "COSINE", "params": {"ef": 128}},
    consistency_level="Strong",
)
使用 BGE-small-en-v1.5 编码同一组查询并检索 vector_a,即可得到替换前的评测结果。代码包保存了逐查询的相关文献标注、召回文献 ID 和指标,可据此分析具体查询的改善与退化。下图是替换前后的效果对比:
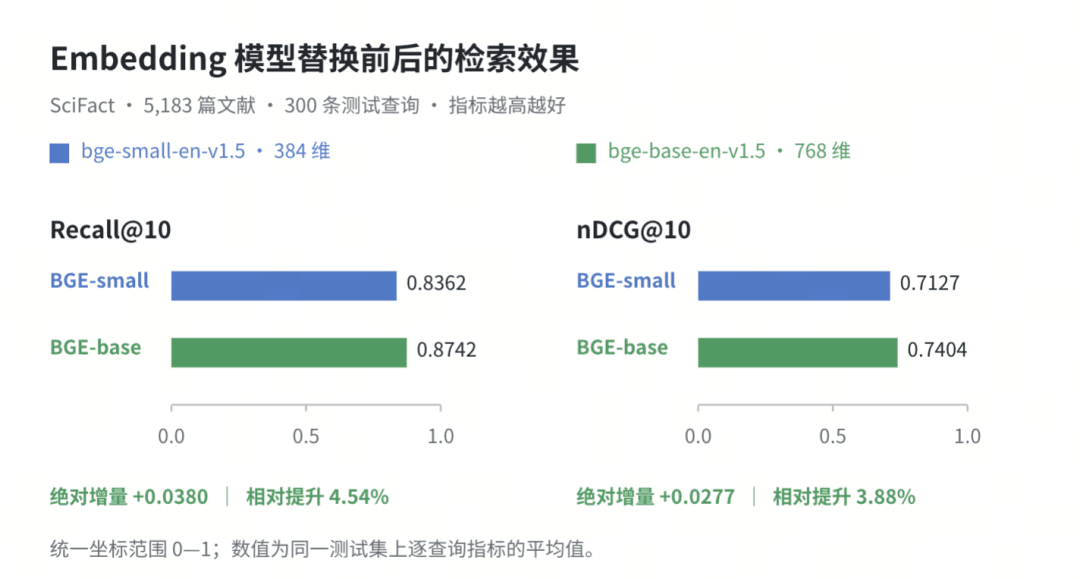 图 2|模型替换前后的检索效果(SciFact)
Step 5:逐步切换流量,保留回滚能力
离线验证通过后,先将部分请求交给 BGE-base-en-v1.5,观察检索质量、延迟和错误率,再逐步扩大流量比例。观察期内保留 BGE-small-en-v1.5 的推理能力和最新向量,以支持回滚。
将模型与目标字段绑定为一个检索版本,并在请求进入时固定该配置。随后,向量生成和检索均使用同一版本;即使默认版本在请求执行期间发生变化,也不影响当前请求的配置。
routes = {
    "A": (model_a, "vector_a"),
    "B": (model_b, "vector_b"),
}
def search(question, version):
    model, field = routes[version]  # 请求开始时固定这一对配置
    vector = model.encode_queries([question])[0].tolist()
    return client.search(
        name,
        data=[vector],
        anns_field=field,
        limit=10,
        output_fields=["title"],
        search_params={"metric_type": "COSINE", "params": {"ef": 128}},
        consistency_level="Strong",
    )
以下命令展示实验 HTTP 接口的调用方式,通过 version="B" 选择 BGE-base-en-v1.5。自动实验由脚本控制路由,不需要额外手动执行:
curl http://localhost:8080/search \
  -H 'Content-Type: application/json' \
  -d '{"query":"0-dimensional biomaterials show inductive properties.","version":"B"}'
实验通过 30 个请求验证混合版本路由,其中 6 个使用新模型、24 个使用旧模型;该检查不等同于真实用户的效果对照实验。
生产环境可按用户、租户或会话稳定分流。灰度验证通过后,切换默认检索版本:
curl http://localhost:8080/route \
  -H 'Content-Type: application/json' \ -d '{"version":"B"}'
若观察期内新版本的检索效果、延迟或错误率未达到要求,可将后续请求切回 BGE-small-en-v1.5,并保留两列向量。修正问题后,重新执行阶段 4 的验证,再尝试切换。回滚请求如下:
curl http://localhost:8080/route \\
-H 'Content-Type: application/json' -d '{"version":"A"}'
Step 6:删除不再使用的旧向量字段
观察期结束、确认不再需要回滚后,将全部请求切换至新模型,停止旧向量写入,并等待旧版本请求完成,再删除 vector_a。删除后,将无法仅通过切换路由恢复旧模型检索。
本实验采用低并发请求和固定观察间隔;生产部署应通过请求计数或排空机制,确认旧版本请求已经结束。
client.drop_collection_field(name, field_name="vector_a")
print(client.describe_collection(name))
print(client.list_indexes(name))
本次实验中,删除 vector_a 后,其关联索引也被移除,vector_b 及文献主键、标题和正文均保留。仅写入 BGE-base-en-v1.5 向量的新记录仍可正常检索。字段删除后,对象存储中的物理空间由后续后台过程回收。
迁移期间需要为两套向量及索引预留资源,并承担额外的模型推理成本。
总结
借助 Milvus 3.0 的在线加减列能力,Embedding 模型升级可以分步平滑完成:旧模型继续服务,新模型独立回填并验证效果,再同步切换查询模型和向量字段。观察期内保留并更新旧向量以支持回滚,确认无需回滚后再删除旧字段。本次 SciFact 实验中,替换为 BGE-base-en-v1.5 后,Recall@10 从 0.8362 提升至 0.8742。完整代码与复现步骤见GitHub 仓库(https://github.com/JackLCL/milvus-embedding-model-migration)。
 李成龙
继续阅读
模型训练中,如何低成本筛选large top-k数据
大 TopK 训练数据检索成本为何升高?解析 IVF、Reservoir 和 AutoIndex 如何优化索引扫描、候选维护与分布式查询。
RAG 优化(三):如何优化LLM-as-Judge ,提升RAG 回答准确性
学习如何工程化校准 LLM-as-Judge,降低评分偏差与漂移,提升 RAG 回答准确性。
实战 | 从 Loop 到 Graph Engineering ,怎样让 Agent 系统长期、可靠地运行
解析 Loop 与 Graph Engineering 的协同机制,涵盖任务驱动、角色分权、异步反馈和上下文检索,构建长期可靠运行的 Agent 系统。