百亿向量、100+场景、1000QPS,美团的Milvus生产级实践分享
作为国内最大的本地生活服务平台之一,美团的业务覆盖外卖、到店餐饮、消费评价、酒店旅游、生鲜零售和即时零售等多个领域,连接着海量商家、消费者和配送骑手。
支撑如此庞大且复杂的业务体系,美团也成为亚洲规模最大的科技公司之一。近年来,AI 已经深入美团的各类业务。从智能客服到商家经营工具,再到推荐系统和多模态搜索,越来越多的业务开始利用大模型提升服务效率和用户体验。
目前,美团内部已有超过 100 个业务场景使用 RAG、Agent Memory和多模态搜索等技术。
这些应用的业务逻辑各不相同,但底层都离不开一项关键能力:从海量向量数据中快速找到相关信息,并结合业务条件进行精准过滤。
为了让不同业务团队都能方便地使用这项能力,美团数据库团队选择了Milvus向量数据库,并以此为基础搭建了统一的向量检索平台。经过约一年的建设,平台承载的向量数据已超过 100 亿条,成为美团 AI 应用的重要基础设施。
01 业务挑战:如何同时满足不同 AI 场景的向量检索需求?
随着 AI 在美团内部的应用越来越广,向量检索需求也呈现出明显的多样化特点。
不同业务使用的向量数据类型、维度和索引算法并不相同,对检索性能的要求也有很大差异。有些业务只有几百万条向量,有些则达到数亿甚至数十亿条。数据库团队需要在同一套基础设施上支持这些业务,同时兼顾查询性能、资源利用率和运维成本。
美团最初使用 Elasticsearch 来承担向量检索任务。但随着数据规模不断增长,原有方案在性能和成本方面逐渐难以满足业务需求。
一方面,Elasticsearch 当时支持的向量维度上限为 4,096,导致可以选择的向量数据类型和索引算法都比较有限,难以灵活适配不同业务的需求。
另一方面, Elasticsearch 方案不支持磁盘向量索引,向量数据需要全部放在内存中。对于数据量达到数亿条的业务,把全部数据都放在内存中,成本不可小觑。
也是因此,美团需要一款原生面向向量检索设计的数据库,既能支持不同类型的向量数据和索引算法,也能通过磁盘索引承载超大规模数据,避免存储成本随着数据增长而急剧上升。
02 技术选型:为什么选择 Milvus?
美团数据库团队对市面上所有常见的主流向量数据库进行了评估,重点考察了功能、性能和开源生态三个方面,最终选择了 Milvus。
在功能方面,Milvus 能够满足不同业务对向量检索的多样化需求。
Milvus 支持丰富的向量数据类型和索引算法,既能服务常规规模的向量检索,也提供面向海量数据的磁盘索引方案。
尤其是磁盘索引,可以让大部分向量数据保存在磁盘上,大幅减少内存占用。对于美团这样拥有十亿级向量数据的业务来说,这一点十分重要。
此外,Milvus 采用存算分离架构,计算与存储资源可以根据业务需求灵活扩展,有利于提高资源利用率,控制大规模部署的成本。
在性能方面,Milvus 的实测结果也满足了美团的要求。
美团使用 1 亿条 768 维向量数据进行了性能测试。在采用 HNSW 索引的情况下,Milvus 在约 1,000 QPS 的查询负载下,P99 延迟为 8.1 毫秒,召回率超过 97%。
这意味着,Milvus 不仅能够满足美团现阶段的向量检索需求,也为未来业务增长留出了足够的性能空间。
在开源生态方面,Milvus 的成熟度也降低了业务接入和平台建设的门槛。
Milvus 提供了完善的 SDK 和技术文档,拥有活跃的开发者社区,GitHub Star 数量超过 4.6 万。同时,美团内部部分团队正在使用的开源 AI 框架已经支持 Milvus,可以直接完成对接,减少额外的开发和集成工作。
综合考虑功能、性能、成本和生态后,美团最终决定引入 Milvus,并在现有 Elasticsearch 基础上形成双引擎架构,由 Milvus 重点承载不断增长的向量检索业务。
03 平台建设:如何让不同业务团队都能方便地使用 Milvus
完成技术选型后,美团面临的下一个问题,是如何让 Milvus 真正服务于公司内部大量、且需求各异的业务。
目前,美团使用 Milvus 的场景涵盖 RAG、知识库、Agent Memory、智能客服、智能诊断、推荐系统和多模态搜索等。
从数据规模来看,大部分业务拥有数百万到数千万条向量,维度主要集中在 768 到 1,536 之间,查询负载通常在 100 QPS 左右。也有少数超大规模业务,其中最大的单个业务已经超过 20 亿条向量。
如果让每个业务团队自行部署和维护 Milvus,不仅会带来大量重复建设,也会增加业务接入和后续运维的成本。
因此,美团由数据库团队统一建设 Milvus 平台,为业务方提供开箱即用的向量检索服务。业务团队无须了解底层集群的部署和维护细节,就能直接使用生产级的向量数据库能力。
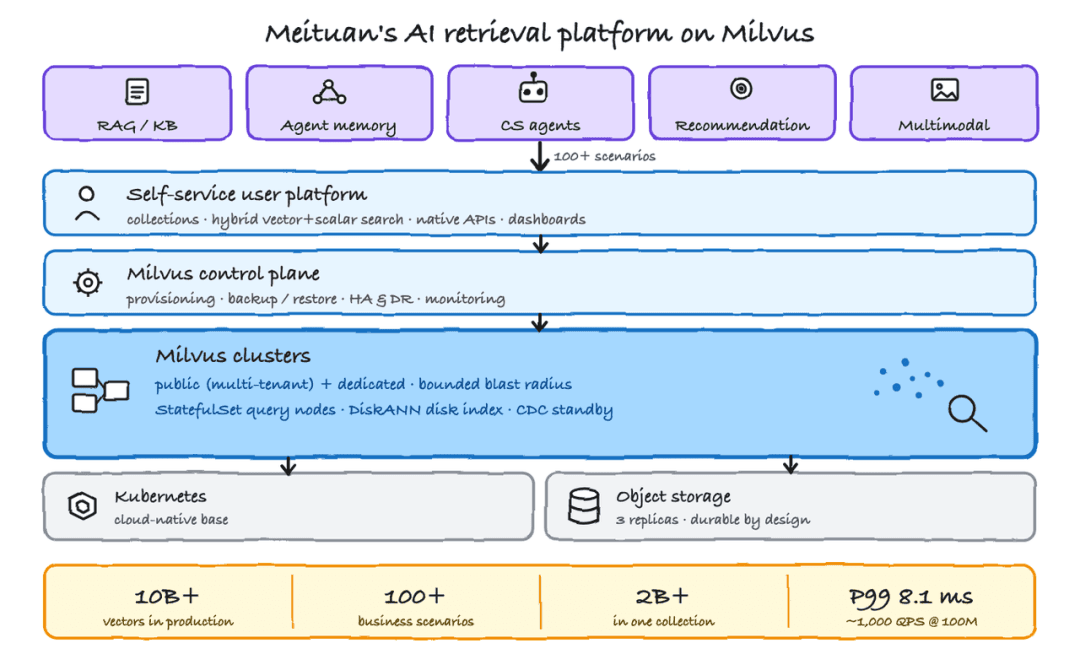
为了让这套平台同时满足不同规模、不同重要程度的业务需求,美团主要围绕存储成本、多租户隔离、高可用和平台自服务四个方面进行了设计和优化。
3.1 利用磁盘索引降低十亿级向量数据的成本
对于向量数据规模达到数十亿条的业务,存储成本是首先需要解决的问题。
Milvus 提供的 DiskANN 磁盘索引,让美团可以将大部分向量数据从内存挪到磁盘中,这样即使单个业务的向量规模达到 20 亿条,也能将整体资源开销控制在可接受范围内。
不过,在实际部署过程中,美团发现,磁盘索引对本地存储空间的需求较大,而标准部署方案中 QueryNode 可使用的本地磁盘容量不足以满足要求。
为了解决这一问题,美团为相关节点挂载了独立的数据卷,并对开源 Milvus Operator 进行了调整,使用 Kubernetes StatefulSet 管理节点,使每个节点在重启后仍能保留自己的磁盘空间。
由于 Milvus Operator 本身也是开源的,美团无须对底层系统进行大规模改造就可以根据自身环境灵活修改部署方式。
3.2 共享集群与独立集群结合,兼顾资源利用率和业务隔离
美团内部接入 Milvus 的业务数量多,规模差异也很大。如果全部使用独立集群,会造成资源浪费;但如果所有业务都放在一起,又容易出现相互影响的问题。
为此,美团采用了共享集群与独立集群相结合的部署方式。
对于规模较小、资源需求相对有限的业务,美团将它们统一放在共享集群中,通过 Milvus 的多租能力实现租户隔离,提高集群的整体资源利用率。
而对于数据规模较大、查询负载较高,或对可用性和性能有特殊要求的业务,则分配独立集群。
按照目前的平台管理策略,向量数据超过 100 万条、需要较高 QPS、属于关键业务,或者需要独立调整性能参数的场景,都会考虑使用独立集群。
共享集群还需要解决资源争抢的问题。例如,某个租户突然出现异常查询或资源使用量激增,可能会影响同一集群上的其他业务。
为了控制这种风险,美团限制了每个共享集群的租户数量,并在新业务接入时,根据业务类型、重要程度和数据规模评估其资源需求,再决定将其部署到哪个集群。
3.3 优化故障切换与容灾机制,保障核心业务稳定运行
当越来越多的生产业务依赖 Milvus,平台的可用性也变得更加重要。
Milvus 采用存算分离架构,数据存储在对象存储中,并通过三副本机制保障数据可靠性。因此,美团在高可用方面的工作,主要集中在如何保证服务持续可访问,以及发生故障后如何尽快完成切换。
其中一个重点是 Proxy 节点的故障处理。
业务客户端需要通过 Proxy 访问 Milvus。如果某个 Proxy 出现故障,客户端必须能够及时切换到其他健康节点,避免请求长时间失败。
为此,美团在自研的 Python 和 Java Milvus SDK 中加入了故障切换机制。
平台控制面负责维护健康 Proxy 节点列表,并将最新列表同步给 SDK。客户端可以直接选择可用节点发起请求。当某个 Proxy 出现异常时,平台也会及时将其从可用列表中移除,使后续请求自动切换到其他节点。
有了这套机制,美团就不需要在每个 Milvus 集群前额外部署独立的负载均衡器,减少了系统组件和运维开销。
除了单节点故障,美团还考虑了机房级别的容灾问题。
在部署 Milvus 集群时,团队会尽量将不同组件分散到多个数据中心,优先实现 Proxy 和协调组件的跨机房部署,再逐步覆盖其他中间件,确保各组件在不同可用区之间均衡分布,并保留 N+1 冗余能力。
对于无法接受长时间服务中断的核心业务,美团还利用 Milvus 的 CDC(变更数据捕获)能力,将主集群的数据持续同步到备用集群。当主集群发生整体故障时,备用集群可以接管服务,进一步提高业务连续性。
3.4 自助式服务,一个小团队如何兼顾全公司的Milvus集群运维
随着接入业务不断增多,如果 Collection 创建、数据管理、集群监控等日常操作都由数据库团队负责,运维压力会非常大。
因此,美团在统一管理 Milvus 集群的基础上,也建设了一套面向业务团队的自服务平台,将常用操作开放给业务方。
通过可视化管理界面,业务团队可以自行创建、删除、加载和释放 Collection,也能一键接入 Milvus 原生 API,使用向量与标量混合检索能力。
平台还提供监控看板和数据库级权限管理,方便业务团队查看服务运行状态,并按需管理数据访问权限。
在数据管理方面,平台支持数据库级别的自动备份,同时建设了数据同步通道,可以从 Hive、RDS 等数据源导入数据,也可以将数据同步到其他环境,用于容灾等场景。
这些日常操作交由业务团队自行完成后,数据库团队便可以将更多精力投入平台稳定性、性能优化和基础设施建设。
最终,美团用一支规模较小的平台团队,就能够管理大量 Milvus 集群,为全公司不同业务提供稳定的向量检索服务。
04 实践成果:一年承载超过 100 亿条向量数据
经过约一年的建设,Milvus 已经成为美团 AI 业务的重要数据基础设施。
目前,美团 Milvus 平台在生产环境中承载的向量数据超过 100 亿条,覆盖 100 多个业务场景。平台已经实现集群自动化交付、数据备份和自服务管理,显著降低了大规模部署带来的运维压力。
在数据规模方面,最大的单个业务已经超过 20 亿条向量,并且不需要重新设计系统架构,就能继续扩展数据规模。
在检索性能方面,美团针对 1 亿条 768 维向量进行的测试显示,Milvus 在约 1,000 QPS 的负载下,P99 延迟为 8.1 毫秒,召回率超过 97%。由于目前大多数业务的查询负载都在 100 QPS 以下,平台能够为这些业务提供充足的性能余量。
在成本方面,DiskANN 等磁盘索引技术有效降低了大规模向量检索对内存的依赖,让单业务 20 亿条向量的部署成本保持在合理水平。美团还在继续研发自有的磁盘索引方案,希望进一步降低十亿级数据场景下的资源开销。
随着 RAG 和 Agent Memory等应用快速发展,Milvus 承载的业务还在持续增加。统一平台让新业务不必再从头部署向量数据库,业务团队可以直接使用现有的检索能力,把研发精力集中在 AI 应用本身。
05 未来规划:升级 Milvus 2.6,持续投入磁盘索引和 Agent Memory
随着 AI 业务对向量检索的需求持续增长,美团也在进一步扩展 Milvus 的使用范围,并围绕版本升级、索引优化和 Agent Memory平台开展新的工作。
目前,美团新建的 Milvus 集群已经默认使用 2.6 版本,现有业务也在逐步迁移。 随着版本升级,团队计划使用内置 Embedding functions等新功能,进一步简化向量数据处理和 AI 应用开发流程。
在底层索引方面,美团正在基于 Milvus 2.6 开发自研的量化磁盘索引。 这项工作的重点是继续提升十亿级向量检索的资源利用效率,进一步降低超大规模业务的运行成本。
与此同时,Agent Memory也成为美团下一阶段的重要建设方向。
随着 Agent 在更多业务中落地,业务团队对记忆管理和知识库能力的需求越来越多。美团计划基于 Milvus 及其开源生态,建设平台级的 Agent Memory能力,为内部团队提供开箱即用的记忆和知识库组件,减少重复开发。
 Zilliz