为什么我们放弃了Kafka、Pulsar,让WoodPecker承担Milvus3.0的写入工作
对一个工程团队来说,数据库的显性成本主要来自于存储与查询,但与此同时,文档更新、用户行为写入、商品特征刷新、Embedding模型升级后的重嵌入等等写入行为也是系统成本的一大重要组成。
多数时候它虽然不会被单独计费,但也会被打包进其他部分的定价中,成为账单的一部分。
那么如何降低写入的成本,同时保证写入链路可靠、延时可控,以及 WAL、网络、存储和后台维护成本可控?
Milvus 3.0 的 Woodpecker 通过把 WAL 从外部 MQ收回,变成数据库架构的一部分重新设计,想要解决的就是这个问题。
以下是 Woodpecker 的思路详解:
01
数据库的写入成本贵在哪里?
我们看写入成本,不能只看用户调用一次写入 API 花了多少资源,因为 API 只是入口,后面还有一连串工作。数据进来之后,系统首先要把日志可靠地存下来,并复制到其他节点,保证故障时数据不丢,这是持久化和复制成本;
接着,要让新写入的数据能够被查询,这会消耗计算和内存资源;
为了保证访问速度,一部分热数据还会留在本地盘,留多少、留多久,也会影响存储成本;
同时,后台还要不断构建索引、合并和整理数据文件,也就是 compaction,这些操作都会持续消耗计算和磁盘读写资源。
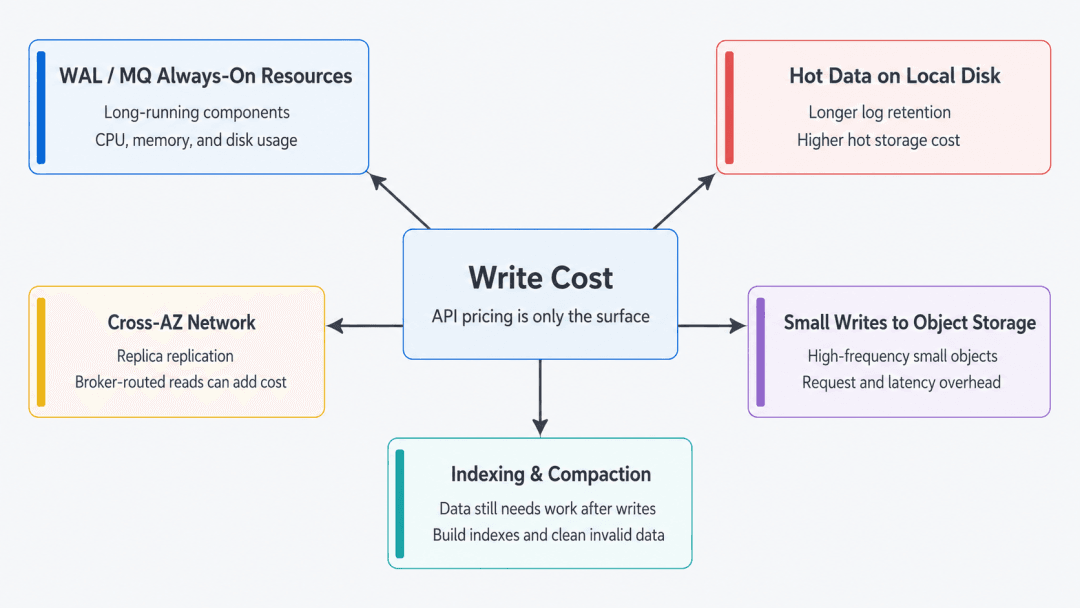
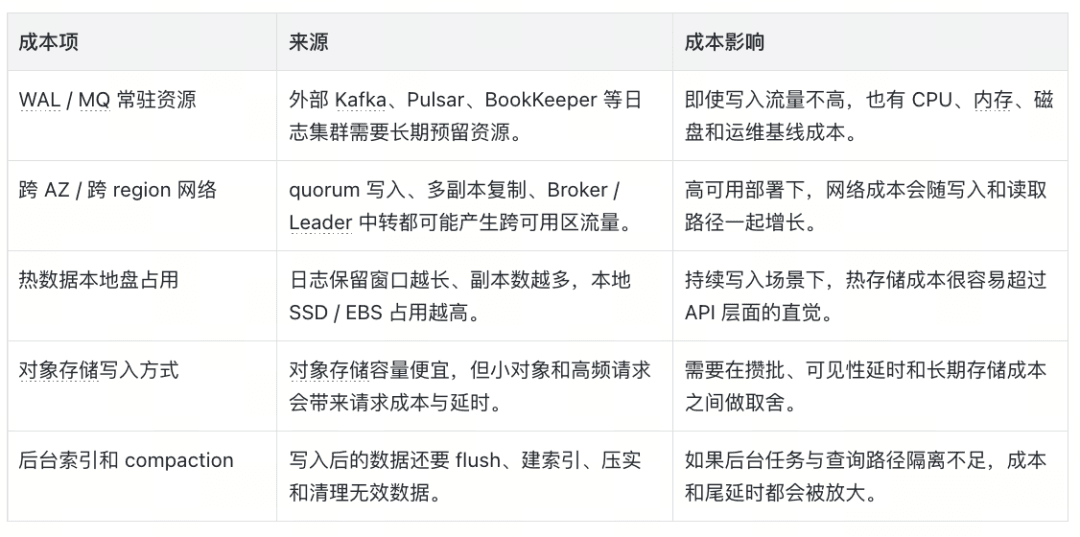
所以,要判断写入成本,关键是看一条数据写进去以后,系统还要为它做多少工作,以及这些工作会持续多久。想清楚写入后哪些路径必须同步完成,哪些工作可以异步批处理,哪些数据应该留在热存储,哪些应该尽快转入对象存储。
02
传统 WAL 在云上为什么会变贵
众所周知,WAL(Write-Ahead Log,预写日志)是数据库保障数据可靠性并实现高效写入的重要基础设施。为了获得更好的可扩展性,WAL 可以从数据库进程中解耦,由独立的持久化基础设施负责。Kafka、Pulsar、BookKeeper 等系统,都曾被用于承担这一角色。
这种架构在很多场景下依然是成熟且可靠的选择。但对于云上的向量数据库而言,在持续高吞吐写入场景下,引入一套独立的 WAL 基础设施,也意味着需要长期维护一套额外的计算资源、网络以及热存储。
即便部分系统后来引入了对象存储和分层存储(Tiered Storage),数据在底层仍然需要经过日志服务内部的复制,协调本地与云端的数据生命周期,并维护副本一致性。单独来看,每一层设计都很合理;但当这些机制叠加到云环境的网络、存储和资源计费模型中,整体成本往往会被层层放大。
也是在这一背景下,Milvus 的 WAL 架构经历了从单机 RocksMQ、集群 Kafka/Pulsar,再到 Woodpecker 的演进。
其中,最新的Woodpecker 的核心逻辑不是重造一个消息队列,而是将日志写入、数据复制、读取以及对象存储的生命周期,彻底放进同一套成本模型中进行极致的重新设计。
03
Woodpecker:Milvus 原生、为云设计的 WAL
Woodpecker是 Milvus 原生的 WAL 实现,设计目标是减少外部日志系统在云上的固定资源、网络和存储开销。它参考了 BookKeeper 的分布式日志模型,同时把对象存储和可用区拓扑纳入写入路径设计。
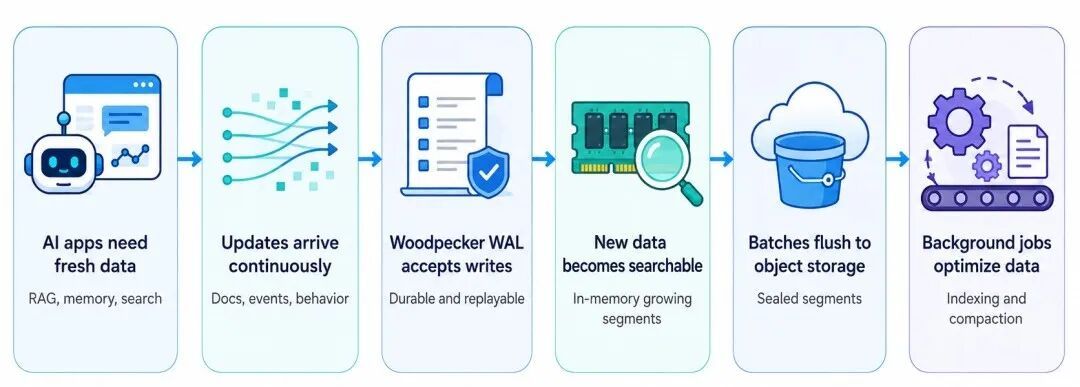
在写入路径上,WAL 的第一职责是以可恢复的方式记录写入顺序。Milvus 接收到 SDK / API 写入后,先将日志追加到 WAL;确认可靠接收后,增量数据进入内存中的 growing segment,随后按阈值 flush 成 sealed segment 到对象存储。索引构建和 compaction 仍在后台异步完成。
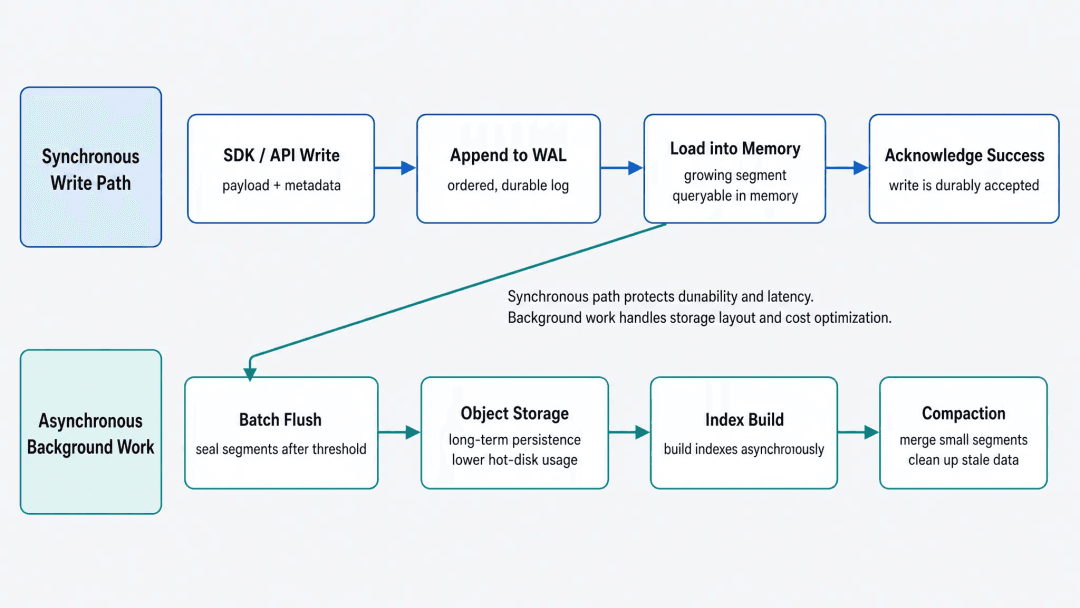
而为了降低成本,需要尽可能减少同步路径上的开销,减少各种不需要的中转、复制,把批处理工作后移,并让长期数据尽早进入更便宜的存储层。
基于这个思路,Milvus 3.0 的 Woodpecker 提供了 Embed 和 Service 两种模式:Embed 更偏向吞吐和基础设施成本优化,适合批量导入、周期性同步、历史数据回灌等对写入延时不敏感的场景;Service 更偏向写入链路的低延时和高可用,适合持续增量写入、对写入稳定性和实时性要求更高的业务场景。
04
Embed 模式:吞吐优先、基础设施更轻
当前,Embed 模式已经在 Milvus 2.6 中已经发布。它本质上是在内存中攒批后直接写入对象存储:数据在内存里攒一小批,直接写进对象存储,不需要额外运行 Kafka、Pulsar 这类常驻日志服务集群。
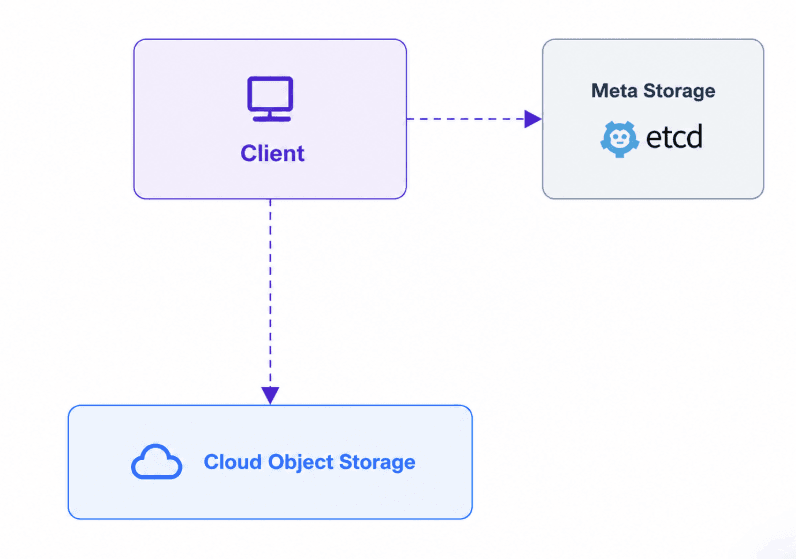
好处是几乎没有额外的基础设施成本,你只需要为存储介质本身付费,钱全花在刀刃上。代价是延时会高一点,因为攒批意味着要等一个小小的时间窗口。
所以它适合那些"更在意整体吞吐、不那么在意单条延时"的业务。如果你的场景正好是这样,Embed 模式几乎是最优解,额外基础设施成本趋近于 0。
但问题来了:如果我既要成本低、又要延时低呢?难道只能退回去用 Pulsar?——这正是 Milvus 3.0 要回答的问题。
05
Service 模式(Milvus 3.0新功能):低延时写入下的成本控制
Service 模式面向另一类场景:对延时和可用性有要求,但仍希望避免传统外部 MQ 的固定资源和跨 AZ 开销。它的核心不是更便宜,而是在数据路径上减少不必要的中转和复制。
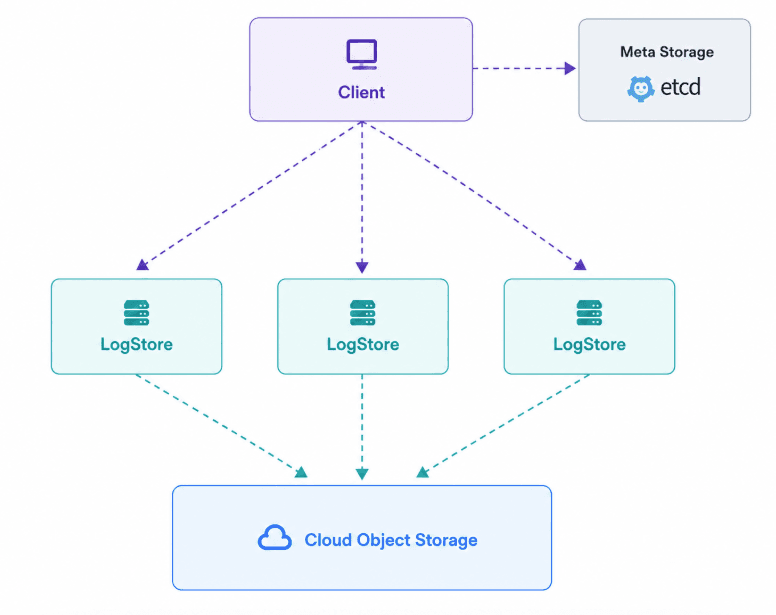
它在延时和成本之间做了更聪明的权衡:延时压了下来,成本依然非常可控。秘诀主要在以下几个地方。
1. 1RTT 多副本写,减少不必要的跨 AZ 流量
Woodpecker 采用 client-driven replication,由客户端负责协调一次写入涉及的多个副本,并在一个 RTT 内完成 quorum 写入。跨 AZ 网络流量固定为2份副本的数据量。而传统日志系统通常需要先经过 Broker 或 Leader 节点,再完成多副本复制, 这个过程有1份数据可能2/3概率跨可用区,2份是固定的跨可用区流量费用。相比 Woodpecker 固定两份副本跨 AZ 网络流量,传统方案理论上约增加三分之一的跨 AZ 网络流量。
2. 拓扑感知与就近直读,降低读取路径成本
Service 模式是拓扑感知(topology-aware)的,每次读取都尽量读离自己最近的副本,而且是单跳直读(single-hop read)。相比需要经过 Broker 转发的数据路径,Woodpecker 可以直接访问目标副本,减少中间转发带来的额外延迟。
很多日志系统读取时需要经过 Broker 等中间层,并且不会优先选择同 AZ 的副本进行读取,读取可能是随机的节点/副本, 这样算下来每次读有2/3概率跨可用区,中间的跨可用区流量费用不可忽略。
3. Segment Rolling 后及时上传对象存储,减少热盘占用
很多类似系统为了用上 S3/OSS 的低价,会把一部分 MQ 数据传到对象存储,但它们本来不是为云设计的,需要维护对象存储与本地存储之间的数据映射和元数据,两套存储之间的数据一致性维护更加复杂。
Woodpecker 不一样:首先在日志流中进行segment分片,每个 Segment 都维护完整的生命周期状态,因此能够明确知道当前位于本地还是对象存储;Segment Rolling 后即可将整个 Segment 上传到对象存储,本地盘占用压到最低,存储成本也跟着降下来。
4. Failover 不依赖整节点数据复制
传统 IDC 的多副本,是节点之间互相拷一份一致的数据,这在云上很不友好——跨 AZ 要收费,节点 failover 又频繁(云上还常用 spot 这类随时可能被回收的机型)。来回拷贝既慢又贵,还给单点带来压力。Woodpecker 干脆不这么干,而是将日志持久化到对象存储,由对象存储承担共享存储的角色。这样的设计有三个直接收益:
Failover 时无需整节点复制数据,只需将存活副本及时上传对象存储即可快速恢复副本,而无需等待整节点数据复制完成。
对象存储具备几乎无限扩展能力,不再受节点间复制带宽限制。
大规模节点替换时,不会出现整节点数据重新复制导致的网络、磁盘洪峰。
这套云原生设计带来的收益在于:在典型三副本跨 AZ 部署下, 同等硬件下写入延时仍保持毫秒级,与传统三副本本地盘方案处于同一量级。在跨可用区部署时,写入还能节省约1/3跨可用区流量费用,读取则节省约2/3流量费用。存储则看设置的消费位点和业务写入流量不同场景来比较成本,核心是这个时间段内对象存储成本和三副本本地盘成本的价差。
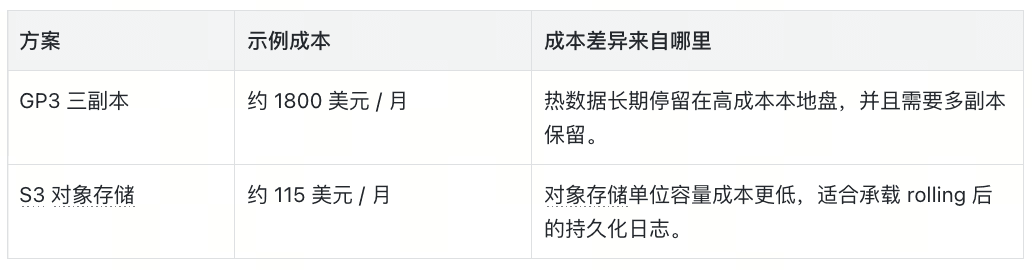
例如 AWS GP3 三副本与 S3 的单位存储成本约相差 15 倍。当日志能够在 Segment Rolling 后及时迁移到对象存储时,长期保存在本地 SSD 的数据量显著减少,在持续写入场景下可以节省大量存储成本。
06
成本计算示例
以持续稳定写入 20 MB/s、本地盘保留 72 小时为例,如果日志长期保留在三副本 GP3 本地盘上,每月存储成本约为 1800 美元;如果 rolling 后尽快迁移到 S3,对应成本约为 115 美元,存储成本差价1650美元每月。
写入路径理论上可减少一个副本的2/3概率跨网络流量,同样以20MB/s稳定写入流量为例,即每月写入流量费用节省:20MB/s * 1个月 * 0.02$/GB * 2/3 = 691.2 美元
读取路径理论上可减少约 2/3 的跨可用区网络流量费用,即每月读取流量费用节省:20MB/s * 1个月 * 0.02$/GB * 2/3 = 691.2美元
注: 当然不同场景可以设置不同的消费位点来节省存储的费用,但毕竟是两套系统,即使设置的只有1个小时后上传对象存储,如果这1个小时内上传的速度足够快(1GB/s),这个数据量依然会保持很高(3.5TB),这个成本依然随着使用的方式有波动,这都是因为它们不基于云存储设计导致的底层技术原因。Woodpecker 则不同,写入再快也会按照 Segment Rolling 策略持续切分日志,并及时上传对象存储,即使发生突发写入,本地磁盘中长期保留的数据也仅限于最近尚未 Rolling 的少量 Segment。
按照 AWS US East (Chicago)(2026-06-30)价格计算: GP3:0.12 美元 / GB-month, S3 Standard:0.023 美元 / GB-month
AWS 跨可用区发送方与接收方分别收取0.01/ GB, 综合成本为0.02/GB。
实际账单会随云厂商、区域、折扣、保留窗口、流量模型和业务消费位点变化。
07
Embed 与 Service 怎么选?
Woodpecker 的 Embed 和 Service 并不是“低配版”和“高配版”的关系,而是两种面向不同工程约束的部署形态。两者采用相同的 WAL 核心能力,但拥有不同的持久化路径、成本模型和运维方式。选型时,更重要的是结合业务写入模式、数据可见性要求、部署方式以及云资源模型进行综合评估。
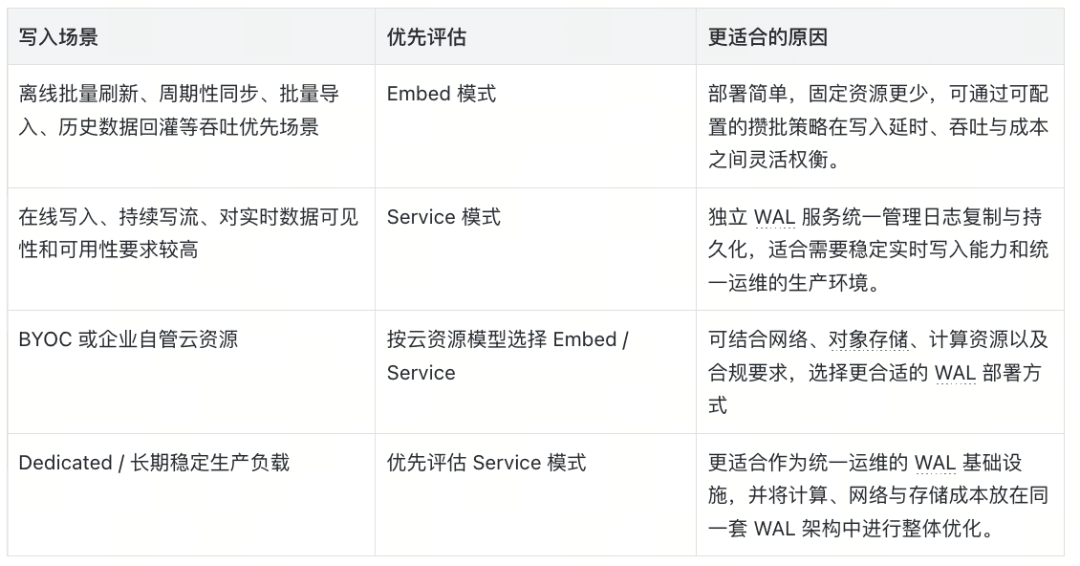
简单来说,Woodpecker 可以让工程团队根据部署规模、资源成本、运维方式以及云资源模型,在 Embed 与 Service 之间自由选择。如果业务更关注部署简单、资源占用更低,并希望通过可配置的攒批策略在写入延时、吞吐和成本之间取得平衡,用Embed;如果业务希望将 WAL 作为独立基础设施部署和统一运维,并对实时写入能力、可靠性和可用性有更高要求,用Service 。
 王舒虹