揭开 Milvus 容量规划工具的神秘面纱
准备部署 Milvus 时,您可能会遇到一系列问题:需要多少 CPU、内存和存储资源?配置少了,担心性能跟不上;配置多了,又可能增加不必要的成本。无论是验证原型,还是准备上线生产环境,提前做好资源估算,都能让后续部署更有把握。
Milvus Sizing Tool 可以帮助您完成这一步。输入向量数量、维度、索引类型等参数后,就能获得一份初步的资源配置建议。本文将带您了解该工具的使用方法,以及这些参数为什么会影响资源需求和检索性能。
您可以把估算结果作为起点,再用实际数据和查询流量进行测试,逐步找到适合业务的配置。
如何使用 Milvus Sizing Tool
使用工具主要分为三步:
打开 Milvus Sizing Tool 页面,选择适用的 Milvus 版本。
输入关键参数:
向量总数和每条向量的维度。
索引类型。
每条记录中标量字段的平均数据大小。
Segment(数据段)大小。
部署模式。
查看工具生成的资源估算和配置建议。
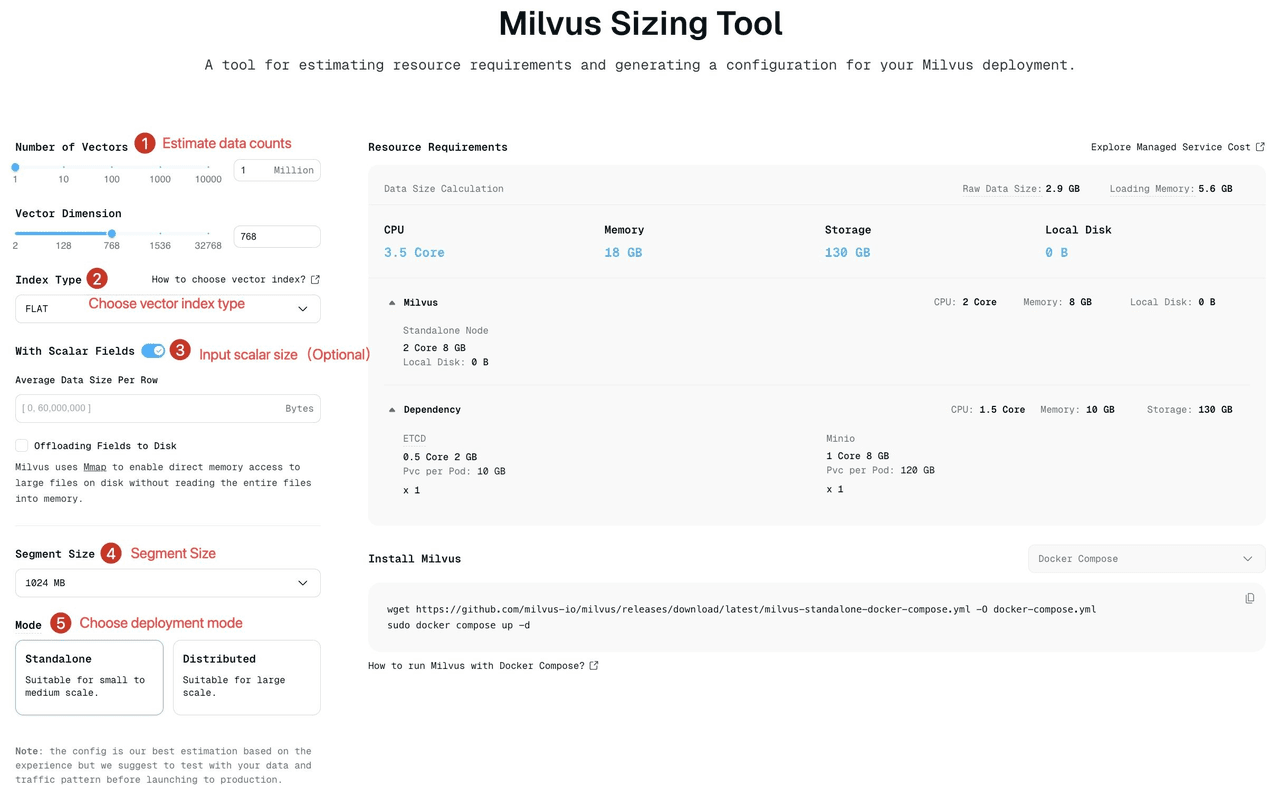 工具界面和可选项可能随版本更新,请以实际页面为准。
索引选择:在存储、成本、召回率与速度之间取舍
Milvus 支持多种向量索引,包括 HNSW、FLAT、IVF_FLAT、IVF_SQ8、ScaNN 和 DiskANN 等。不同算法在内存占用、磁盘空间、查询速度和召回率方面各有侧重。
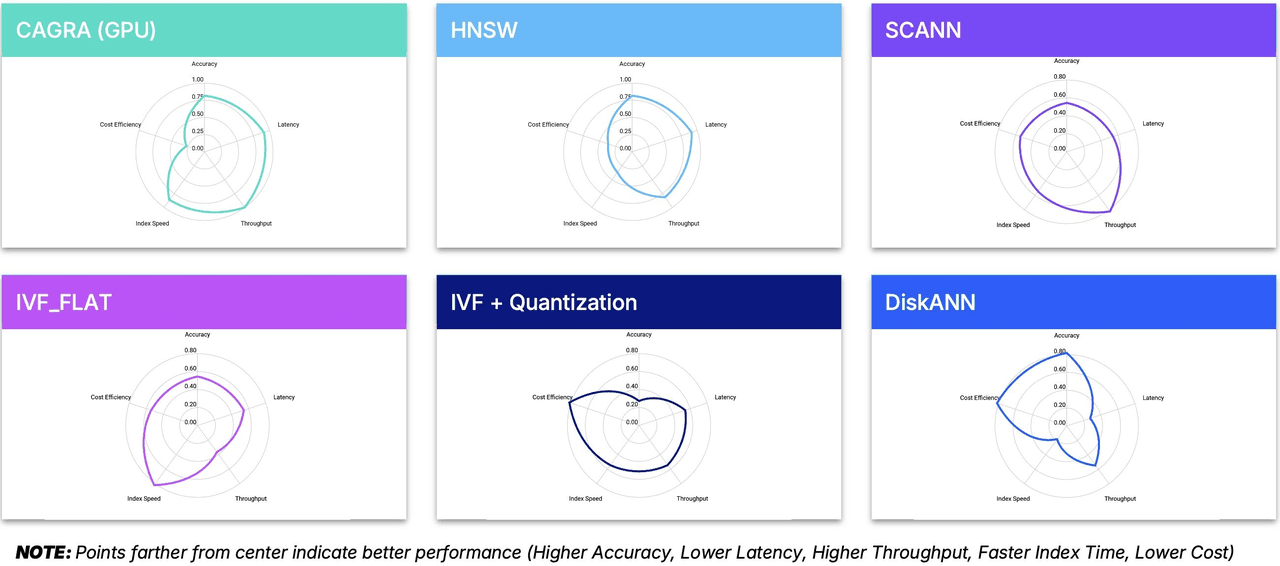
HNSW:适合重视查询速度和召回率的场景
HNSW 的全称是 Hierarchical Navigable Small World,即分层可导航小世界图。
基本结构:采用多层图结构,其分层思想与跳表类似。上层节点较少,负责快速定位大致区域;下层节点更加密集,用于细化搜索。
性能特点:通常能够同时提供较快的查询速度和较高的召回率。
资源需求:除了向量本身,还需要存储图的连接关系,因此内存开销通常高于不压缩向量的 FLAT 或 IVF_FLAT。具体差异取决于向量维度和图参数。
适用场景:对检索速度和召回率要求较高,且有足够内存的应用。
查询从最上层开始,逐层向下寻找更接近查询向量的候选,最终在底层完成更细致的搜索。
FLAT:逐条比较,获得精确结果
基本结构:不进行近似搜索,而是遍历候选向量并计算距离。
性能特点:可以获得精确的最近邻结果,但计算量随数据规模增长。固定维度下,单次查询的扫描复杂度为
O(n);若同时考虑维度d,距离计算量约为O(n × d)。资源需求:向量索引的数据体积与原始向量数据量基本相当,但部署时还需考虑标量字段、运行时缓冲区等额外开销。
适用场景:小规模数据集、需要精确结果的应用,或用于评估近似索引召回率的基准测试。
这里的“精确”指的是按指定距离度量找到最近邻。结果是否符合业务需求,还取决于 Embedding 模型和所采用的距离度量。
IVF_FLAT:通过聚类缩小搜索范围
IVF_FLAT 会先把向量分成多个簇。查询时,只搜索其中较相关的簇,从而减少需要逐条比较的向量数量。
基本结构:将向量划分为多个簇,查询时先定位相关簇,再在这些簇内计算向量距离。
性能特点:通过减少参与比较的向量数量,在查询速度和召回率之间取得平衡。实际表现取决于数据分布及参数设置。
资源需求:不压缩原始向量,因此索引体积通常接近原始向量数据量,并包含聚类中心等额外信息。一般不需要承担 HNSW 的图连接开销。
适用场景:希望通过聚类加速检索,并接受一定近似搜索误差的应用。
使用时,需要重点区分两个参数:
nlist:构建索引时,将向量划分为多少个簇。nprobe:查询时,实际搜索多少个簇。
增加 nprobe 通常有助于提高召回率,但也需要搜索更多向量,查询耗时可能随之增加。您可以结合业务所需的召回率和延迟,逐步调整。
IVF_SQ8:用量化降低向量存储开销
基本结构:在 IVF 的基础上使用标量量化,将每个维度的 32 位浮点值编码为 8 位值。
性能特点:通过压缩表示降低资源需求,但量化误差可能影响召回率。
资源需求:向量编码部分的体积可降至原来的约四分之一。计入索引结构等开销后,官方文档中的示例显示,相比 IVF_FLAT,相关存储和内存占用可降低约 70%~75%。
适用场景:内存或存储资源有限,并能接受一定召回率损失的应用。
估算收益时,您还需要把其他字段和运行开销算进去。向量压缩了,并不意味着整个集群的成本或计算量也会按相同比例下降,最终仍需结合实际负载验证。
更多索引选择:ScaNN、DiskANN、GPU 索引与量化索引
如果您的应用对查询速度、内存占用或数据规模有不同需求,也可以考虑以下索引方案。
ScaNN
ScaNN 面向高效的 CPU 向量检索,可作为 HNSW 之外的候选方案。两者的速度与召回率差异需要结合数据集、硬件和参数实测,不宜将某个测试中的性能提升比例视为普遍结论。
DiskANN
DiskANN 结合磁盘与内存组织索引,适合数据量较大、难以将全部索引常驻内存的场景。它通过让部分数据保留在磁盘上,降低内存需求。
选择 DiskANN 时,需要同时评估磁盘性能、查询延迟和召回率。原文提到的约 100 毫秒只能作为特定场景下的参考,不能视为固定延迟。
GPU 索引
GPU_CAGRA:针对 GPU 优化的图索引,适合评估高吞吐、低延迟的向量检索需求。推理型 GPU 在部分部署中可能更具成本优势,但应按所用 Milvus 版本核对硬件兼容性,不能仅以 GDDR 或 HBM 显存类型判断是否支持。Milvus Documentation
GPU_BRUTE_FORCE:在 GPU 上执行穷举搜索。
GPU_IVF_FLAT:使用 GPU 加速 IVF_FLAT。
GPU_IVF_PQ:结合 GPU 加速与乘积量化(Product Quantization),压缩向量表示。
结合量化的 HNSW 索引
HNSW_SQ:在 HNSW 上使用标量量化,适合希望降低内存占用、同时保持较快查询速度的场景。
HNSW_PQ:使用乘积量化进一步压缩向量,适合内存更加紧张的场景。
HNSW_PRQ:通过乘积残差量化压缩向量,也是需要在内存、查询速度和召回率之间评估的选项。
量化并不保证只产生“轻微”的召回率损失。应使用业务数据测试压缩效果,并确认具体索引在目标版本中的可用性。
AUTOINDEX
AUTOINDEX 提供自动索引选择或配置入口。开源 Milvus 与 Zilliz Cloud 的具体实现有所不同,也可能随版本变化,不宜将它统一理解为某一种固定索引。Zilliz Cloud 还提供其托管服务中的索引优化能力。
二进制、稀疏及其他专用索引
对于二进制向量、稀疏向量等数据,应选择对应的索引类型。完整列表和适用范围可参考 Milvus 索引文档。
Segment 大小与部署配置
Segment(数据段)是 Milvus 组织数据的基本单位。Milvus 将数据划分为多个 Segment,并在不同节点之间分配检索任务,从而支持分布式搜索和负载均衡。
在 Sizing Tool 中,您可以选择 512 MB、1024 MB 或 2048 MB 的 Segment 大小,默认值为 1024 MB。如果不确定如何选择,可以先参考下面的对应关系:
这份对应关系可以帮助您确定初始配置,但实际能加载多少个 Segment,还取决于索引类型、标量字段、查询并发和运行时的内存开销。
较大的 Segment 通常可以减少数据段数量及相关管理开销,但并不是越大越好。如果您的部署规模较大,可以先从 2 GB 开始测试,再根据内存余量、查询速度和节点间的负载情况进行调整。
另外,工具中的 Segment 大小用于资源估算,并不代表每个 Segment 加载后会占用同样大小的内存。规划时,仍需为索引和运行过程中的额外开销留出空间。
消息队列如何选择
如果您需要在 Pulsar 和 Kafka 之间做选择,可以结合现有基础设施和团队经验来判断:
Pulsar:如果是新项目,可以优先考虑 Pulsar。它在单个 Topic 的资源开销和扩展能力方面具有优势,同时也需要团队具备相应的运维能力。
Kafka:如果您的团队已经在使用 Kafka,并建立了成熟的监控和运维流程,继续复用现有设施通常会更方便。
这里主要比较这两种方案。不同 Milvus 版本支持的消息存储方案可能有所不同,部署前,建议您查看所用版本的官方文档,确认可用选项和配置要求。
Zilliz Cloud 能提供企业级优化
如果您的生产应用对性能要求较高,又希望减少基础设施运维工作,可以考虑使用 Milvus 原厂团队提供的全托管服务 Zilliz Cloud。它在内存管理、数据合并和冷热数据存储等方面提供了进一步优化:
内存管理与 OOM 风险控制:通过内存管理机制,降低因内存不足导致服务异常的风险,帮助应用更稳定地运行。
Compaction 优化:优化数据段合并,减少数据碎片,改善检索性能和资源利用率。
冷热数据分层:根据数据的访问频率选择合适的存储与计算配置,在性能和成本之间取得平衡。
选择计算单元(CU)时,您可以根据数据的访问情况来判断:经常查询的数据适合使用标准 CU;不常访问的数据则可以考虑分层存储 CU,以降低存储成本。具体支持的规格和部署区域,请以产品文档为准。
如果您想进一步了解服务方案和资源配置,可以查看 Zilliz Cloud 服务方案文档和资源规划文档。
部署配置时,还需要注意什么?
1. 不同索引配置,建议分别估算
如果您的不同 Collection 使用了不同索引,可以分别运行估算,再汇总资源需求,这样更容易看清各类业务的资源开销。
每次估算都对应一组具体的数据和索引配置。如果 Collection 之间的数据规模或索引策略差异较大,建议分别评估,避免直接套用同一份结果。
2. 内存预算,别忘了索引和运行开销
估算内存时,除了向量本身,还需要为索引结构、标量字段,以及查询和后台任务留出空间。
HNSW 的内存需求有时会达到原始向量数据量的 2~3 倍,但这个范围只能作为经验参考。向量维度、图连接参数和加载方式都会影响实际占用。您可以先用工具估算,再通过测试确认内存预算是否充足。
3. 上线前,用真实查询验证配置
拿到配置建议后,建议您选取一批有代表性的数据,按照接近实际业务的方式进行测试,包括查询并发、过滤条件和返回结果数量,再检查召回率与延迟是否达到预期。
这样既能确认数据是否装得下,也能验证系统在实际访问压力下是否跑得稳。
4. 为增长留一些余量
如果您的数据量和查询流量还在增长,规划时可以适当留出余量,减少频繁调整配置的工作。不过,也不必一开始就为所有远期需求准备资源。
您可以根据数据增长速度、资源利用率和查询表现,明确什么时候需要扩容,再逐步调整投入。
总结
Milvus Sizing Tool 能帮助您建立初步的资源预算,也方便比较不同索引、Segment 大小和部署模式下的配置需求。
有了这份参考,再结合实际数据和查询负载进行测试,就能更有依据地调整资源,在召回率、延迟和成本之间找到适合业务的平衡。
如果您在估算过程中遇到问题,欢迎到 GitHub Discussions 或 Discord 与社区交流。带上您的数据规模、查询需求和当前配置,也能帮助大家给出更具体的建议。
参考资料
 张粲宇