针对Chroma停服,Zilliz Cloud对受影响用户提供免费迁移指导与额度支持
日前,旧金山向量数据库玩家Chroma 团队正式官宣加入其早期投资人 Amjad Masad 旗下的在线编程平台 Replit。
与此同时,Chroma 旗下托管云服务 Chroma Cloud 将逐步停服:2026 年 11 月 22 日起停止写入、进入只读状态,12 月 22 日起全面停止读取服务,所有线上数据将不再可访问。
对于正在基于 Chroma Cloud 搭建业务的开发者与团队,两个月的迁移窗口对于完成数据备份导出、新方案选型验证、业务平滑切流来说,每一步都容错空间都非常有限。
为帮助受影响的开发者维持业务连续性,作为全球领先的向量数据库产品,Zilliz Cloud 将面向 全球Chroma 用户提供专项迁移支持。
本次专项支持包括:
1 对 1 技术指导。专属技术专家将协助完成数据导出方案设计、目标实例规格匹配、应用接口适配和切换验证。
免费使用额度。从 Chroma 迁移至 Zilliz Cloud 的新用户,可获得保底 300 元人民币免费使用额度,用于迁移验证与初期业务运行。根据选择的 Zilliz Cloud 版本不同,最高可获得 200 美元免费额度支持。
有迁移需求的开发者,可根据本文教程完成迁移,或者扫描文章底部二维码提交申请,我们的专家团队会在1 个工作日内与你对接。
下面介绍完整的迁移流程:
01 迁移前准备
开始迁移之前,需要先确认连接条件、目标容量和数据映射规则。这些信息会直接影响迁移方式的选择,以及后续应用代码的调整。
Zilliz Cloud 集群及连接凭证:准备目标集群的公网端点和 API 密钥,并确认目标数据库已经存在。如果还没有 Zilliz Cloud 账号,请先完成注册并创建集群。
Chroma 连接信息:使用 Chroma Cloud 时,可在控制台的 Connect 面板中找到 API 密钥、租户 ID、数据库名称和连接端点。使用自建 Chroma 时,需要准备服务器地址;如果启用了身份验证,还需要准备相应的令牌,或用户名和密码。
Python 环境:准备 Python 3.10 或更高版本,并安装客户端。后续将用它们检查源数据、验证迁移结果和调整应用代码:
pip install chromadb==1.5.9 pymilvus==3.0.2
Docker:如果使用开源 Vector Transport Service完成迁移,需要安装 Docker,并确保运行容器的机器能够访问 Chroma 和目标数据库。
02 迁移后的数据结构说明
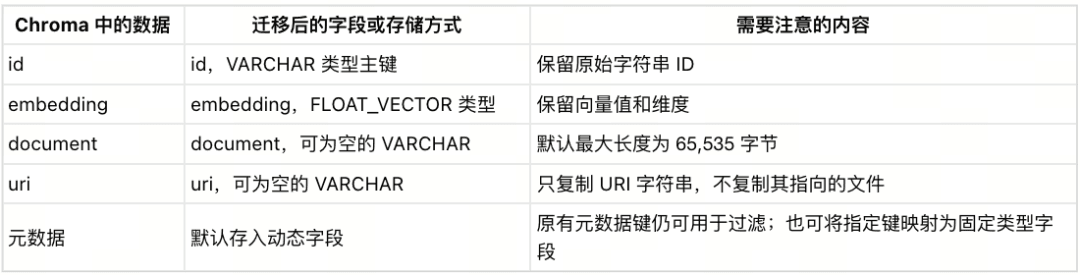
正式开始迁移前,你可以先了解 Chroma 与 Zilliz Cloud 的字段、集合映射规则,便于后续校验数据、改造应用代码。
2.1核心字段映射如下
2.2集合命名规则
集合名称也需要检查。默认情况下,名称中的连字符 - 会被替换为下划线 _,例如:
support-docs → support_docs
Zilliz Cloud 集合名称只能包含字母、数字和下划线,且不能以数字开头。对于 kb.v2、2024-notes 等名称,需要在迁移配置中调整。同时要检查名称冲突。例如,support-docs 和 support_docs 转换后会得到相同名称,需要修改其中一个。
完整的字段映射规则,以及将元数据转换为指定类型字段的方法,请参阅文末文档。
2.3距离度量对应关系
Chroma 中的距离空间与 Zilliz Cloud 的索引度量类型一一对应,迁移后需手动为目标集合配置匹配的度量类型,否则会导致检索结果偏差:cosine → COSINE;l2 → L2;ip → IP
注意:Embedding Function不会随数据一同迁移,迁移后仍需在应用侧使用原模型生成向量。
2.4集合数量限制说明
每个 Chroma 集合都会迁移为一个独立的 Zilliz Cloud 集合,不同的 Zilliz Cloud 集群规格有对应的集合数量上限:Free 集群最多支持 5 个集合,Serverless 集群最多支持 100 个;Dedicated 集群每个计算单元支持 1,024 个集合,集群上限为 16,384 个。
若你的集合数量已超出对应规格上限,或为百万级租户的多集合场景,可联系我们获取专属的升级与切换方案。
03 迁移数据:根据源端网络环境选择方式
根据 Chroma 的部署环境与网络条件,我们提供两种迁移方案,你可以按需选择:
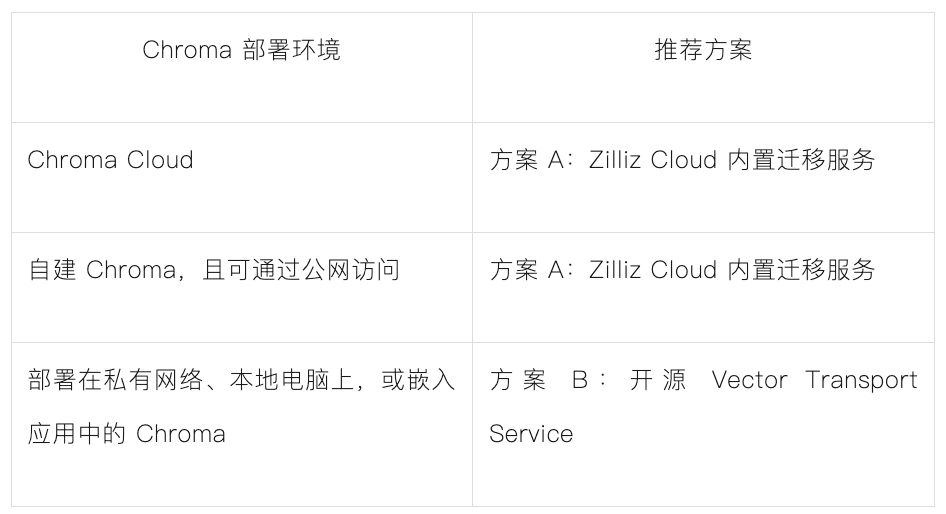
其中,内置迁移服务运行在 Zilliz Cloud 服务端,需要主动访问源端 Chroma,因此要求源端可被 Zilliz Cloud 网络访问;Vector Transport Service(VTS)可部署在你自己的机器上,只要该机器可同时访问源端与目标端,即可执行迁移。
迁移开始前,建议先统计源端各集合的记录数与距离空间,用于后续校验迁移完整性、配置目标索引。你可以通过以下脚本快速获取:
import chromadb
client = chromadb.HttpClient(host="localhost", port=8000)
# Chroma Cloud:
# client = chromadb.CloudClient(api_key=..., tenant=..., database=...)
for collection in client.list_collections():
    config = collection.configuration_json
    space = (
        (config.get("hnsw") or config.get("spann") or {}).get("space")
        or "l2"
    )
    print(f"{collection.name}: {collection.count()} 条记录,距离空间:{space}")
注:如果创建集合时没有指定距离空间,Chroma 默认使用 l2。另外,空集合需要单独处理,Chroma 只有在写入第一个向量后才会记录向量维度,迁移工具无法据此为一个空集合创建对应的目标集合。
方案 A:使用 Zilliz Cloud 内置迁移服务
迁移服务内置于 Zilliz Cloud 控制台,可免费使用。但注意,操作账号需要具备Organization Owner或Project Admin权限。
若源端为自建 Chroma,需确保服务对外提供 Chroma REST API v2,且网络可被 Zilliz Cloud 访问;若源端在防火墙后,需将 Zilliz Cloud 的 IP 地址加入白名单。
第一步:配置源端和目标端连接
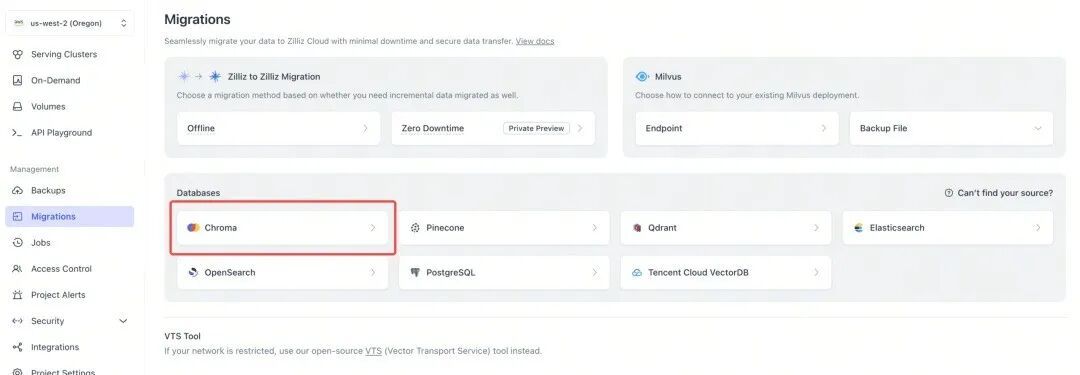
在控制台中打开Migrations,选择Chroma作为数据源,填写端点、租户、数据库和认证信息。
使用 Chroma Cloud 时,从 Connect 面板复制实际连接信息。端点通常为 https://api.trychroma.com;如果数据库不在 AWS us-east-1 区域,请使用所在区域的端点。
自建 Chroma 支持的认证方式包括无认证、令牌认证,以及用户名和密码认证。默认租户和数据库名称分别为: default_tenant 和 default_database。
源端配置完成后,选择目标集群和数据库。
第二步:选择集合并检查映射
选择需要迁移的集合,并逐一检查:目标集合名称是否合法、是否与已有名称冲突;向量字段及维度是否正确;文档、URI 和元数据字段是否符合预期;是否需要将部分元数据键转换为固定类型字段。
默认将元数据存入动态字段即可保留其灵活性。如果业务需要明确的字段类型或约束,可以在映射阶段进行调整。
第三步:设置索引参数
保持Create indexes after migration开启,并确认各集合使用与源端一致的度量类型::cosine → COSINE;l2 → L2;ip → IP
不要仅因两端字段和向量维度相同,就跳过这一步。度量类型设置错误时,数据仍可能成功迁入,但搜索结果会出现偏差。
第四步:启动任务,检查索引并加载集合
提交任务后,可以在Jobs页面查看进度、错误信息和验证行数。任务完成后,检查索引是否创建成功,再加载集合。即使启用了自动创建索引,也需要确认集合已经加载,才能继续进行搜索验证
方案 B:使用 Vector Transport Service
Vector Transport Service(VTS)是 Zilliz 的开源迁移工具,也是 Zilliz Cloud 迁移服务使用的底层引擎。你可以编写配置文件,在自己的环境中通过 Docker 运行迁移任务。
本方案通过 Chroma REST API v2 连接源端,源服务器需要提供这一接口(Chroma 0.6 及以上版本的服务器均提供该接口。)
第一步:让本地 Chroma 数据可通过服务访问
如果应用使用 chromadb.PersistentClient,将 Chroma 数据保存在本地目录中,需要先基于该目录启动 Chroma 服务器,供 VTS 连接:
chroma run --path ./chroma_data --port 8000
第二步:编写迁移配置
将以下内容保存为 migration.conf,并将所有以 $ 开头的占位符替换为实际值。
注意:配置中的占位符不是环境变量,VTS 不会自动替换。
env {
  parallelism = 1
  job.mode = "BATCH"
}
source {
  ChromaDB {
    url = "$CHROMA_URL"                  # 例如 http://host.docker.internal:8000
    tenant = "default_tenant"
    database = "default_database"
    collections = ["$CHROMA_COLLECTION"] # 例如 ["support-docs"]
    # 如果 Chroma 启用了身份验证,请参考下表
    # auth_type = "X_CHROMA_TOKEN"
    # token = "$CHROMA_TOKEN"
    id_split_size = 300
    batch_size = 300
  }
}
sink {
  Milvus {
    url = "$ZILLIZ_CLOUD_ENDPOINT"
    token = "$ZILLIZ_CLOUD_API_KEY"
    database = "default"        # 数据库必须已存在
    batch_size = 50
    enable_dynamic_field = true # 必须开启,用于存储元数据
    schema_save_mode = "CREATE_SCHEMA_WHEN_NOT_EXIST"
    data_save_mode = "APPEND_DATA"
  }
}
配置文件包含访问凭证,请限制文件权限:
chmod 600 migration.conf
如果需要将部分元数据键映射为固定类型字段,可在目标端配置中添加 field_schema 块,详细参数可参考文末附录文档。
第三步:运行迁移任务
docker run --rm \
  --mount "type=bind,source=$(pwd)/migration.conf,target=/config/migration.conf,readonly" \
  --workdir /opt/seatunnel \
  --entrypoint /bin/bash \
  zilliz/vector-transport-service:v1.3.0 \
  -lc 'mkdir -p logs && ./bin/seatunnel.sh --config /config/migration.conf -m local'
任务成功后,我们会看到:
日志末尾显示 end with state FINISHED。
Total Read Count 与 Total Write Count 相同。
Total Failed Count 为 0。
另外,由于VTS 采用追加写入模式,请勿向同一个目标集合重复执行迁移。 再次运行会将所有记录重新写入。如果任务中途失败,或需要重新获取完整副本,请先删除目标集合,或者通过 collection_rename 将数据写入新集合。
第四步:创建索引并加载集合
使用 VTS 迁入数据后,还需要创建索引并加载集合。下面以 COSINE 为例;如果源集合使用 l2 或 ip,请改为对应的 L2 或 IP。
from pymilvus import MilvusClient
client = MilvusClient(
    uri="YOUR_ZILLIZ_CLOUD_ENDPOINT",
    token="YOUR_ZILLIZ_CLOUD_API_KEY",
)
index_params = client.prepare_index_params()
index_params.add_index(
    field_name="embedding",
    index_type="AUTOINDEX",
    metric_type="COSINE",  # cosine -> COSINE,l2 -> L2,ip -> IP
)
client.create_index(
    collection_name="support_docs",
    index_params=index_params,
)
client.load_collection("support_docs")
04 验证迁移结果:同时检查数据完整性和搜索结果
迁移任务成功,说明数据搬迁流程已经完成;是否能够承接生产业务,还需要进一步验证。
建议依次检查记录数、记录内容和搜索结果。
4.1 核对记录数
首先,将迁移前记录的源集合数量,与目标集合的实际记录数进行比较。
控制台迁移服务会显示经过验证的行数;使用 VTS 时,可以先检查日志中的 Total Write Count,再核对目标集合中的实际数据。
对于正式切换使用的最终副本,应在源端暂停写入后完成迁移,并确保两端记录数一致。
4.2 核对 ID 和记录内容
记录数相同,不代表内容一定完整。还需要检查:原始 ID 是否全部迁入,向量值与维度是否保留,文档和 URI 是否正确,元数据键、值及类型是否符合预期。
数据量较小时,可以逐条比较;数据量较大时,应核对 ID 完整性,并抽样比较向量、文档、URI 和元数据。
4.3 使用相同查询向量比较搜索结果
即使所有记录都已迁入,索引度量类型不一致仍会影响搜索结果。因此,需要让两端使用相同的查询向量,比较返回的近邻记录。
下面的示例从源集合中取出最多 20 条向量,分别执行搜索,并计算前 10 条结果的平均重合率:
import chromadb
from pymilvus import MilvusClient
chroma = chromadb.CloudClient(
    api_key="YOUR_CHROMA_API_KEY",
    tenant="YOUR_TENANT_ID",
    database="YOUR_DATABASE_NAME",
)
# 自建 Chroma:
# chroma = chromadb.HttpClient(host="localhost", port=8000)
milvus = MilvusClient(
    uri="YOUR_ZILLIZ_CLOUD_ENDPOINT",
    token="YOUR_ZILLIZ_CLOUD_API_KEY",
)
source = chroma.get_collection("support-docs")
overlaps = []
for vector in source.get(limit=20, include=["embeddings"])["embeddings"]:
    expected = source.query(
        query_embeddings=[vector],
        n_results=10,
        include=[],
    )["ids"][0]
    hits = milvus.search(
        "support_docs",
        data=[vector.tolist()],
        limit=10,
    )[0]
    overlaps.append(
        len(set(expected) & {hit["id"] for hit in hits}) / len(expected)
    )
print(f"前 10 条结果的平均重合率:{sum(overlaps) / len(overlaps):.0%}")
由于两个系统使用的都是近似索引,重合率略低于 100% 属于正常情况。如果重合率明显偏低,通常应先检查目标索引的度量类型是否与源集合的距离空间一致。
05 更新应用:接入目标集合,调整查询与写入逻辑
数据验证通过后,需要让应用能够正确使用迁移后的集合。
主要调整包括:连接配置、查询向量生成、过滤表达式、分数阈值,以及写入和删除接口。建议先在预发布环境完成这些修改,再安排正式切换。
5.1 建立 Zilliz Cloud 连接
from pymilvus import MilvusClient
client = MilvusClient(
    uri="YOUR_ZILLIZ_CLOUD_ENDPOINT",
    token="YOUR_ZILLIZ_CLOUD_API_KEY",
)
5.2使用原有Embedding模型生成查询向量。
在 Chroma 中传入 query_texts 时,Chroma 会调用集合配置的Embedding模型,自动生成查询向量。
迁移后,已有向量会保留,但Embedding模型不会随数据一起迁移。因此,需要在应用中继续调用相同的模型,并保持模型版本、维度和相关参数一致。
如果此前由 Chroma 自动生成向量,且没有配置过Embedding模型,那么使用的就是默认模型 all-MiniLM-L6-v2。仍然可以通过 chromadb 包在本地调用:
from chromadb.utils.embedding_functions import DefaultEmbeddingFunction
embed = DefaultEmbeddingFunction()
query_vector = embed(["How do I get a refund?"])[0].tolist()
如果使用 OpenAI 或其他服务提供商的模型,应复用原有模型和参数设置。迁移前请先确认实际配置,避免将不同模型生成的查询向量用于搜索已有数据。
5.3 调整搜索和过滤条件
原来的 Chroma 查询:
from chromadb.utils.embedding_functions import DefaultEmbeddingFunction
embed = DefaultEmbeddingFunction()
query_vector = embed(["How do I get a refund?"])[0].tolist()
迁移后改为:
results = client.search(
    collection_name="support_docs",
    data=[query_vector],
    limit=5,
    filter='category == "billing" and document like "%refund%"',
    output_fields=["document", "category"],
)
PyMilvus 搜索结果中的每条命中记录包含 id 和 distance,请求返回的其他字段放在 entity 中。如果应用直接解析原来的 Chroma 返回结构,也需要同步修改。
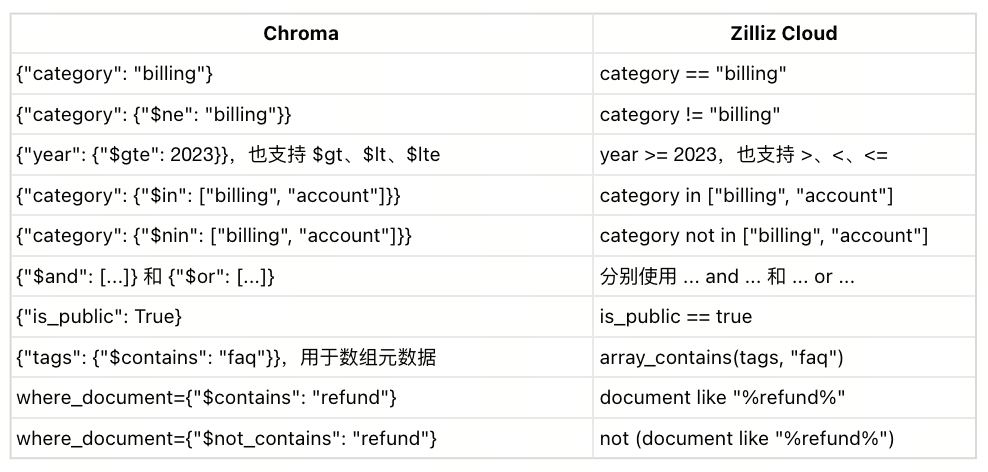
Chroma 的 where 和 where_document 条件,在 Zilliz Cloud 中需要统一写为 filter 表达式:
5.4调整分数阈值
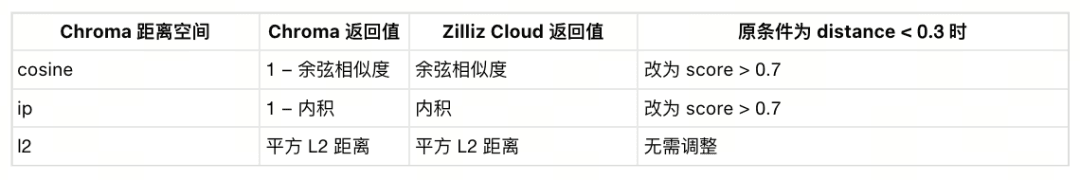
Chroma 返回距离值,数值越小,表示越相似。对于 COSINE 和 IP,Zilliz Cloud 返回相似度分数,数值越大,表示越相似。
结果的排序逻辑不变,但应用中基于分数设置的阈值需要相应调整。
例如,在我们的测试中,上述查询排名第一的结果,在 Chroma 中的距离为 0.0545,在 Zilliz Cloud 中的分数为 0.9455。
5.5调整写入和删除操作。
写入操作中,元数据键会与文档字段平级放入单条记录中,无需单独使用 metadatas 参数。
Chroma 的 add 和 upsert 操作,在 Zilliz Cloud 中统一可使用 upsert;若确定写入的是全新 ID,也可使用 insert。
删除操作支持按 ID 或过滤条件执行,示例如下:
client.upsert(
    collection_name="support_docs",
    data=[
        {
            "id": "doc-1001",
            "embedding": vector,
            "document": "How to change your billing address",
            "category": "billing",
        }
    ],
)
client.delete(
    collection_name="support_docs",
    ids=["doc-1001"],
)
client.delete(
    collection_name="support_docs",
    filter='category == "archived"',
)
注意:写入时使用的向量,必须与集合中已有向量使用相同的嵌入模型生成。uri 字段允许为空,可省略。
5.6 LangChain 应用适配
考虑到大量开发者是通过 LangChain 等主流开发框架对接 Chroma Cloud,我们也整理了极简的向量存储替换方案,只需修改少量代码即可完成底层存储的切换,尽量降低停服带来的改造成本。
先安装 Milvus 集成包:
pip install langchain-milvus
再安装官方适配包,只需替换向量存储的引入类与初始化参数,查询调用的整体结构不变:
from langchain_chroma import Chroma
vector_store = Chroma(
    collection_name="support-docs",
    embedding_function=embeddings,
    chroma_cloud_api_key="YOUR_CHROMA_API_KEY",
    tenant="YOUR_TENANT_ID",
    database="YOUR_DATABASE_NAME",
)
docs = vector_store.similarity_search(
    "How do I get a refund?",
    k=5,
    filter={"category": "billing"},
)
迁移后(Zilliz Cloud / Milvus 代码):
from langchain_milvus import Milvus
vector_store = Milvus(
    embedding_function=embeddings,
    collection_name="support_docs",
    connection_args={
        "uri": "YOUR_ZILLIZ_CLOUD_ENDPOINT",
        "token": "YOUR_ZILLIZ_CLOUD_API_KEY",
    },
    primary_field="id",
    text_field="document",
    vector_field="embedding",
    enable_dynamic_field=True,
)
docs = vector_store.similarity_search(
    "How do I get a refund?",
    k=5,
    expr='category == "billing"',
)
说明:原有 embeddings 可直接复用,无需更换Embedding模型;元数据过滤语法从 filter 字典形式调整为 Milvus 标准的 expr 条件表达式。
06 正式切换:冻结源端写入,迁入最终副本
完成迁移演练和应用适配后,就可以安排正式切换。
本教程采用全量迁移方式。首次演练之后,源端可能继续产生新增、更新和删除,因此正式上线前需要重新获取最终副本。
建议按以下顺序操作:
1. 完成首次迁移和验证。 将预发布环境的应用连接到 Zilliz Cloud,验证应用运行情况。
2. 暂停向 Chroma 写入。 2026 年 11 月 22 日之后,Chroma Cloud 本身也会停止接受写入。
3. 重新迁移完整数据。 确保暂停写入前的所有变更都已迁入,并核对两端记录数是否完全一致。开始前,需要先删除首次迁移的数据,或将此次副本写入另一个数据库。
4. 上线新版应用。 将应用的读写请求切换到 Zilliz Cloud。
5. 处理 Chroma Cloud 凭证。 按照 Chroma 停服通知的要求,在 2026 年 12 月 22 日前删除或轮换相关凭证。
如果您在2026 年 11 月 22 日之后开始迁移,Chroma Cloud 中的数据已经处于只读状态,可以跳过暂停写入这一步,只执行一次完整迁移。数据仍可在 12 月 22 日前迁出。
自建 Chroma 没有停服期限,但仍建议遵循相同顺序:首次迁移、暂停写入、再次迁移、切换服务。
切换后,可以暂时保留原有 Chroma 服务器。在应用尚未向 Zilliz Cloud 写入新数据之前,只需修改连接配置即可回滚。
07 开源Milvus迁移
以上操作同样适用于开源 Milvus 2.5 及以上版本。
与迁入 Zilliz Cloud 相比,主要调整在目标端连接和索引配置:
使用第 03 节的方案 B执行迁移。
将目标 url 改为 Milvus 服务地址。
启用认证时,将 token 设置为 username:password;未启用认证时,删除该配置。
根据目标 Milvus 版本选择兼容的 PyMilvus 客户端,以及支持的索引类型。
此外,Milvus 与 Zilliz Cloud 使用同一套 API,后续如果需要将数据再从Milvus迁移到Zilliz Cloud,无需修改应用的业务代码。
08 更多参考
迁移大规模数据或生产业务:可以扫描文章底部二维码联系我们的支持团队,共同规划切换方案。
其他数据库迁移:本套迁移教程也支持 Pinecone、Qdrant、Elasticsearch、OpenSearch 和 PostgreSQL。
文档《从 Chroma 迁移到 Zilliz Cloud》:https://docs.zilliz.com/docs/migrate-from-chroma
 Zilliz