Aquila语义去重精读:训练数据里的语义重复,白白烧掉了多少 GPU 时?
本系列上一篇内容《为什么每个重复建设 AI 数据 pipeline 的企业,都需要一个 Vector Lakebase》讲了为什么训练、索引和在线检索不再各自复制一套数据,而是共享湖上的同一份数据和索引。
沿着这个思路继续深究,既然数据只存一份,那么哪些治理动作最应该直接发生在湖上?
语义去重首当其冲。 对大规模训练语料来说,重复并不只是偶尔混进来了脏数据,而是多轮抓取、多源汇聚和模型换版之后几乎必然出现的问题。
它最好在数据进入训练之前处理,而不是等 GPU 已经开始为重复样本付费之后再补救。
01
语义重复,对模型训练究竟有何影响?
一个多模态训练团队的数据湖,通常是这样不断完成规模扩张的:
第一轮抓取落下两亿图文对;下个季度并入一批合作方数据;再换一版 embedding 模型,全量重算;然后二次抓取补漏、人工修订回填。半年后湖里躺着八亿样本。
在这个过程中,伴随多轮抓取、多源汇聚、模型换版,出现大量语义重复几乎是难以避免的情况:同一个网页被不同网站转载,同一张商品图被裁剪、压缩或加上水印,同一段说明被复制进多个文档后又分别生成 embedding,都是可能的原因。
即便经过专门的清洗,这个比例也比多数人的直觉高得多。Google 的研究者在 C4 这种 "已经清洗过"的语料里仍找到 3.04% 的近重复文档,其中一句 61 个词的英文句子重复出现了六万多次。
而关于如何去重,文件名、hash 或字符串比只能清掉字节级完全一致的副本,却识别不了这些内容已经发生变化、语义仍高度接近的样本。对于这部分数据,重复关系只有进入 embedding 空间之后才比较容易暴露出来。
它的成本首先体现在训练上。
以公开的 Llama 3.1 405B 为参照做一笔粗比例账(假设算力随 token 线性缩减):15.6 万亿 token 的训练消耗了 3084 万 H100·时——每 1% 的语料对应约 30 万GPU时。如果语料里躺着 LAION 量级(近半)的语义重复,按这个比例烧掉的就是上千万 GPU 时。
而这还只是算力账:Anthropic 的实验给过一个极端案例——只要 0.1% 的数据重复出现一百次,一个 800M 参数模型的性能就会退化到 400M 的水平;Google 的实验则显示数据重复会显著增加模型逐字记忆训练样本的概率。重复不只是浪费算力,也会模影响模型的具体表现。
反过来,去重之后的数据即使数量变少,也不一定意味着模型能力同步下降。Semdedup 在 LAION-440M 上的实验就是一个典型例子:删除将近一半的语义近重复样本后,训练数据量和训练时间都明显下降,而模型效果基本保持。
总之,在大规模训练数据里,去重解决的不是一个单纯的存储问题。它同时影响训练成本、数据有效密度,以及模型对训练样本的记忆方式。 相比许多更复杂的数据治理动作,这通常性价比最高的一步。
类似的问题也会出现在其他 AI 数据负载里。多模态图库和商品库会为重复样本同时支付存储、索引和训练成本;RAG 知识库里,如果 Top-K 召回的三条结果其实来自同一份内容,上下文窗口同样会被重复信息占掉。
不过规模不同,处理方式也不同。单个知识库通常只有百万级 chunk,很多单机工具就能完成扫描;本文讨论的 Spark 链路,主要针对湖上亿级甚至更大的 embedding 数据集。
02
算法:大规模 KMeans + Union-Find,为什么能 work
先看暴力解法为什么不可行。
1 亿条 embedding 全量两两比对,是 5×10¹⁵ 次距离计算——1024 维下,即使单机把吞吐做到每秒一亿次距离,也要连续算一年半。
数据量增加到八亿之后,向量对数量还会再增加约 64 倍。
因此,对去重问题,我们不能只简单思考“怎么把两两比较再优化一点”,而是要想办法怎样尽可能不做全局两两比较。
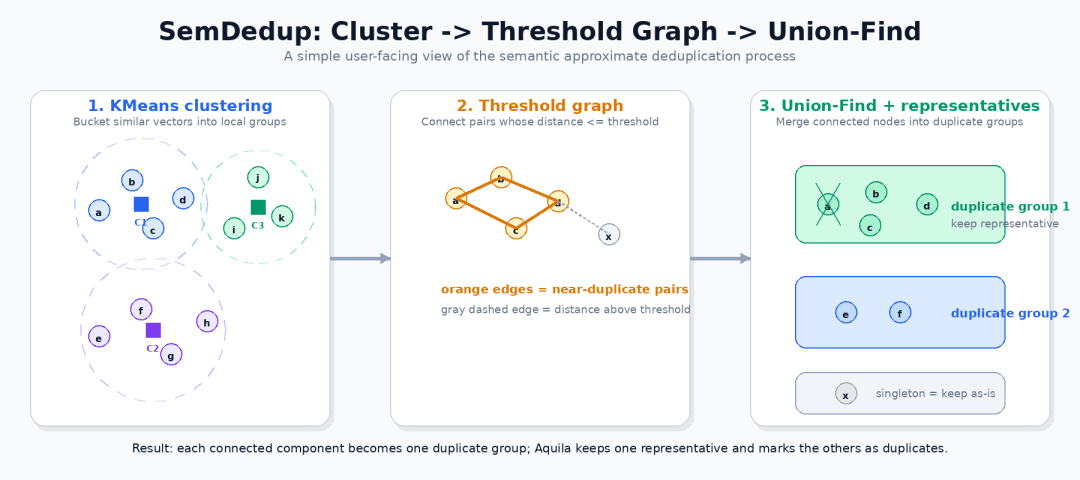
整个过程分四步。
KMeans 粗分桶——把 O(n²) 变成可算的问题。语义重复有一个可利用的性质:近重复样本在 embedding 空间里高度聚集,倾向于落在同一个语义邻域。先用 KMeans 把全量数据切进语义簇,比较就只需要发生在簇内——搜索空间从全局坍缩到局部(跨簇的少量漏配是这一近似的代价,见下方边界)。
按cluster_id重分区。同一语义区域的数据进入同一个执行单元,簇内比较天然并行,互不依赖。
簇内找候选,按分区大小自适应。小分区直接暴力算距离;大分区构建 ANN 索引做阈值候选检索(top-K 或 range search,按配置选择)。判定标准只有一个阈值:cosine 下相似度大于阈值视为重复,l2 下距离小于阈值视为重复。
阈值图 + Union-Find——把"相似对"变成"重复组"。相似本身并不传递(A≈B、B≈C 推不出 A≈C),这里做的是一个明确的工程定义:把阈值内的样本对连边,用阈值图的连通分量定义重复组——A≈B、B≈C 时三者被链式合并进同一组。好处是不依赖两两全部命中,组内连通即可整组找出;代价是阈值偏松时会过度合并,这是需要用阈值与 stats 审计控制的主要风险。每组保留一个代表样本,其余标记为重复。
这套流程它的好处在于:分桶后总成本变成"分桶 O(n·k·d·I)(I 为迭代数)+ 桶内比对 O(n²/k·d)(桶均衡假设)"两项,此消彼长——在迭代数与常数项相对稳定、桶近似均衡时,量级平衡点为 k=Θ(√n):整条链路从 O(n²) 量级降到约 O(n^1.5),1 亿条时计算量比暴力比对少三个数量级;收尾的 Union-Find 近线性,可以忽略。
而这套近线性也决定了它的边界:候选对只在簇内构建,簇边界附近的近重复存在漏配可能, 去重召回不是 100%——所以阈值要么给明确值,要么给目标去重率让运行时校准,并用输出的 stats 审计实际效果。
当然,“先聚类,再在局部空间里消重”本身并不是 Aquila 独有的路线。NVIDIA NeMo Curator 已经应用了SemDeDup算法作为他们数据处理的一部分。Aquila 更主要的区别,在于这套流程如何将数亿级 embedding 数据放进分布式批处理场景中。
最终结果主要提供两个字段:component_id 表示样本属于哪个阈值连通分量,is_representative 表示这个组最终保留哪一条。
用户既可以保留全量映射用于审计和回表,也可以直接拿去重后的代表样本继续训练或建索引。
03
Aquila 的实现,怎么把这套算法跑到亿级数据上
算法并不复杂。真正麻烦的是,当输入数据规模从几百万向量变成几十亿甚至更多之后,大规模数据的峰值内存和shuffle,以及故障恢复都会影响整条链路能不能在分布式场景稳定跑完。
Aquila 主要从两层处理这个问题。
第一层:用近似换速度——本质是 Cardinal 能力的外化。
Aquila 不是"把任务交给 Spark 跑"这么简单。链路里所有算得慢的地方,都被换成了 Zilliz 在向量检索系统里沉淀多年的近似计算能力(Cardinal 内核)
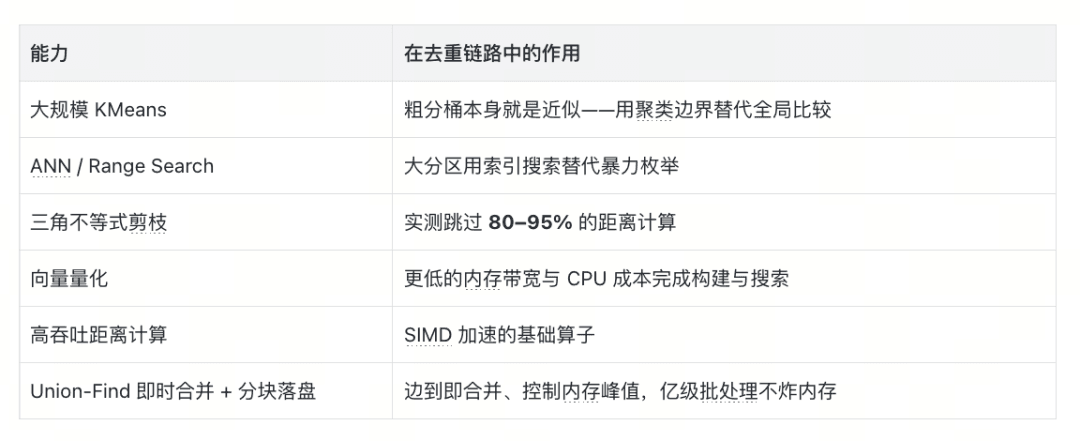
在线检索场景锤炼出来的这套能力——建索引、近似搜索、量化、剪枝——被外化到湖上批处理:同一套内核,在线服务毫秒级查询,离线批量吞吐治理。
在 LAION 100M 子集、k=2048、相似性阈值< 0.9 的一组基准参数下,当前实现识别出的近重复样本比例约为 55%。
这个数字与 Meta 在完整 LAION 上观察到的大量冗余处于相近量级。
第二层:托管——云平台沉淀的工程与运维。
算法可以开源实现,但真正自己跑起来,还需要处理另一组问题:Spark 集群怎么配,算子参数怎么配(KMeans 分多少桶,大分区用什么索引,阈值怎么找),任务失败以后从哪里恢复,底层向量库升级后怎样保持作业稳定。
Aquila把这些细节 托管在云平台上:作业提交即运行,规模伸缩、容错重试、参数缺省和内核升级由平台持续沉淀和维护。用户消费的是"去重"这个语义,而不是它背后的运维栈。
04
不止去重:Aquila 的算子家族
语义去重是 Aquila 的核心算子,但湖上数据治理不止这一刀。zilliz 湖上的batch job 还提供:
精确 / PK 去重:按主键或指定字段的确定性去重,它的成本最低,适合在语义去重之前先清掉完全重复;
KMeans聚类:数据分布分析与语义分桶——训练前知道"数据集里到底有什么";
异常检测(Isolation Forest):从整体分布里找离群与低质样本,发现那 0.1% 的长尾。
其中 KMeans 与异常检测和语义去重共享同一套 Cardinal 内核与湖上执行框架。它们的输出都写回湖里,与去重结果一样被下游的索引、训练和检索直接消费——数据只存一份,治理只做一次,所有 AI 负载复用。
结语
对比一下前后两种工作方式。
以前给训练语料做一轮语义去重:把数据从湖里导出,自己写 Spark 脚本,阈值拍脑袋定,跑到一半 OOM 重来,跑完了没人说得清到底去掉了多少、该不该信。
现在:数据不动,一次作业,targetDedupRate 说人话,stats 给审计——去重从一个数据工程项目,变成一个带质量报告的例行动作。等 Loon 存储引擎的多引擎写入路径随版本开放后,这份治理产出还将以 Manifest 提交的方式原子生效、线上直接切换。
如果 Vector Lakebase 让 AI 数据终于可以住在同一个地方,那么 Aquila 的语义去重回答的是训练开始前的第一个问题 :这些数据里,有多少值得花GPU时?
在数据进入模型之前先回答它,后面的每一步——训练、索引、存储、检索——都在为更少而更好的数据付费。
目前,Zilliz Vector Lakebase public preview 已发布,湖上批处理能力(含语义去重)在逐步开放中,如有需要,请在后台联系我们。
 程倩雅